# 标准化、归一化(正规化、规范化)、正则化
标准化(standardization)和归一化(正规化、规范化,normalization)都是数据预处理的方法。另外还有一个中文很相似但并非一种预处理方法的正则化(regularization)。简单区分一下:
## 标准化(standardization)
$$x^{*}=\frac{ x-\mu}{\sigma }$$
也就是【零居中(zero-centered)】【除以标准差】,这种方法称为Z-score标准化。将数据按比例缩放,使其落入到一个小的区间内,标准化后的数据可正可负,但是一般绝对值不会太大。
标准化不会改变数据的分布规律,而仅仅是让各个维度的数据都期望0,方差1。特别地,如果原始数据本身就是正态分布,则这一过程可将其转换为标准正态分布(概率统计经典套路)
## 归一化(正规化、规范化,normalization)
借用[知乎gokenu的结论](https://www.zhihu.com/question/20467170/answer/633379185)。其实归一化和标准化都属于四种Feature scaling(特征缩放),这四种分别是:
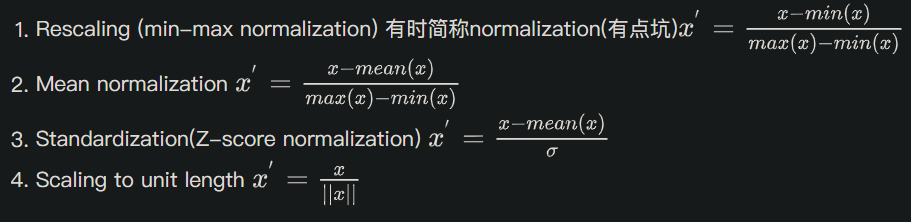
中文翻译时,归一化指前两种(尤指1),标准化指第3种。其实可以看到,这些特征缩放互相之间都有一些共通之处,比如:
- min-max归一化(1)和mean归一化(2)都采用了【除以最大距离】,这保证数据的模长都小于等于1;特别是min-max归一化,还保证大于等于0
- mean归一化(2)和z-score标准化(3)都采用了【零居中(zero-centered)】,这保证数据围绕0点分布,期望为0
整理如下:
- min-max归一化:保证数据分布于[0,1]之间
- mean归一化:保证数据分布于[-1,1]之间,且期望为0
- z-score标准化:保证数据的期望为0,方差为1;一般可使数据不太大,但并不是每一个数据与均值的差都小于等于标准差,因此不能保证数据分布于[-1,1]之间(这可能也是我们不叫它归一化的原因)
> gokenu: 然后关于在ML里面是用第一个好还是第三个好,感觉大家都讨论的很激烈.有的认为取决于你的数据的特点(是否稀疏),有的认为取决于数据是否有明确的界限. 个人不太赞同只有归一化让椭圆变成了圆的想法,在我的梯度下降中,两种都加速得挺好...
## 正则化(regularization)
正则化根本就不是数据预处理方法,而是在损失函数中添加一个惩罚项,用来调整拟合程度。常用基于L1、L2范数的正则化。
![]()