# 图论和树上问题
## 简单概念
- 平面图:没有$K_5$和$K_{3,3}$作为子图的图,可以让边不相交地绘制在平面上
- 拓扑排序:记录入度,遍历一个节点就把其连接的节点入度-1,循环+深度遍历所有入度为0的节点即可。
- 
- 欧拉路径:过所有边一次
- 无向图:没有奇点有回路,有2个奇点有路径
- 有向图:没有合度不为0的点有回路,有2个合度不为0的点有路径
- 打印路径:以任意点或一个奇点为起点,按边深搜遍历所有的边(注意不是按点,一个点可以经过多次),后序输出
- 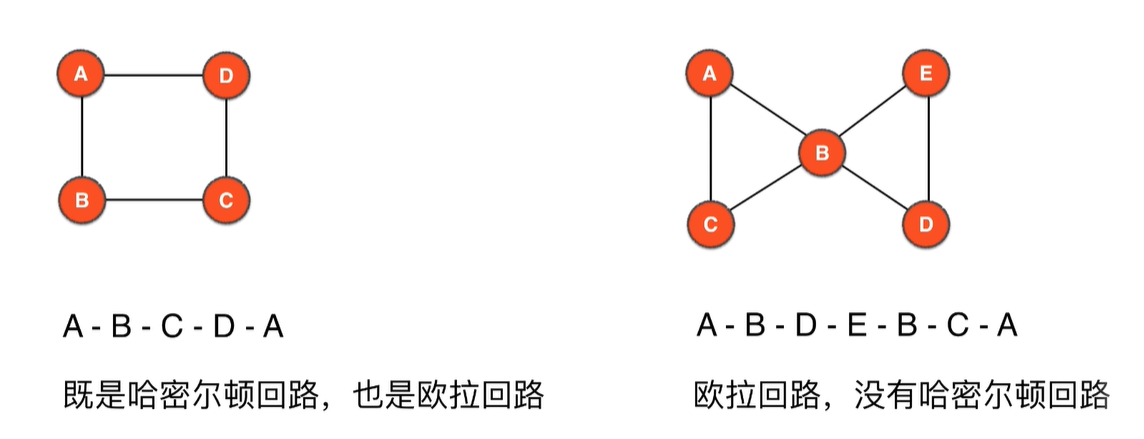
- 哈密顿路径:过所有点一次
- 有冠军的两两竞赛图中存在哈密顿路径,不存在哈密顿回路
- 无冠军的两两竞赛图中存在哈密顿回路
- 两两之间严格分胜负的竞赛图构成全序关系
- 
## 最短路径
- Floyd:kij
- 初始化:自己到自己为0,
- 输出路径:用pass数组记录每个ij最后一次松弛使用的k,最终可��递归输出路径path(i,k)和path(k,j),i=j不输出,`pass[i][j]==默认值`直接输出`从i到j`。默认值为0或-1
```cpp
int n, m;
int G[MAXN][MAXN], dis[MAXN][MAXN], last[MAXN][MAXN];
void init() {
// 自己为0,其它为INF
for (int i = 0; i < n; i++)
for (int j = 0; j < n; j++)
G[i][j] = (i == j) ? 0 : INF;
}
void floyd() {
memcpy(dis, G, sizeof(dis)); // cpy
memset(last, -1, sizeof(last)); // set
for (int k = 0; k < n; k++) {
for (int i = 0; i < n; i++) {
for (int j = 0; j < n; j++) {
// 松弛及记录路径
if (dis[i][j] > dis[i][k] + dis[k][j]) {
dis[i][j] = dis[i][k] + dis[k][j];
last[i][j] = k;
}
}
}
}
}
// 逆推获得路径
void get_path(int a, int b) {
int k = last[a][b];
if (a == b) return; // 相等不输出
if (k == -1) { // 直连输出起点
cout<<a<<" ";
return;
}
get_path(a, k); // 分治
get_path(k, b);
}
```
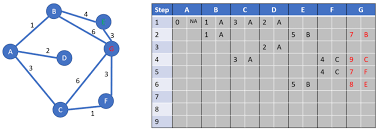
- Dijkstra:
- 使用`pair<dis, id>`优先队列,每轮直接把松弛结果加进去,取的时候使用id标记位确定当前pair是否还有用,没用就删掉,也就是可删除优先队列
- 初始将源点的直连节点加入优先队列
- 每次从优先队列中取一个距离最近的未标记节点并打标记,对其他未标记节点进行松弛然后加入优先队列,
- 也可以用`last`数组记录每个节点最后一次松弛是用哪个节点,然后直接线性递推到源点即可输出路径,`last`默认值为0或-1
- 
```cpp
int n, m, dis[MAXN], last[MAXN];
vector<pair<int, int>> G[MAXN];
// 一定注意优先队列默认是大根,要改成小根
struct Comp {
bool operator()(pair<int, int> a, pair<int, int> b){
return a.second > b.second;
}
};
void dijkstra(int st) {
// 初始化last为-1,dis为起点邻居权值或INF
memset(last, -1, sizeof(last));
for(int i = 0; i < n; i++)
dis[i] = INF;
priority_queue<pair<int, int>, deque<pair<int, int> >, Comp> candi;
// 起点直接打标记,邻居进优先队列
int book[n] = {0};
book[st] = 1;
for(int i = 0; i < G[st].size(); i++) {
candi.push(G[st][i]);
dis[G[st][i].first] = G[st][i].second;
}
while(!candi.empty()) {
// 找第一个未标记的最近点
pair<int, int> next;
do {
next = candi.top();
candi.pop();
} while (book[next.first] && !candi.empty());
if (book[next.first]) break; // 没有可用最近点就跳出
book[next.first] = 1; // 标记已使用
// 尝试用最近点松弛它邻接的每个未标记节点并记录路径、添加候选
for(int i = 0; i < G[next.first].size(); i++) {
pair<int, int> to = G[next.first][i];
if (book[to.first]) continue;
if (dis[to.first] > dis[next.first] + to.second) {
last[to.first] = next.first;
dis[to.first] = dis[next.first] + to.second;
candi.push(make_pair(to.first, dis[to.first]));
}
}
}
}
// 逆推打印路径
void get_path(int x) {
if (x == -1) return;
int k = last[x];
get_path(k);
cout << x << " ";
}
```
- xSPFA
## 最小生成树
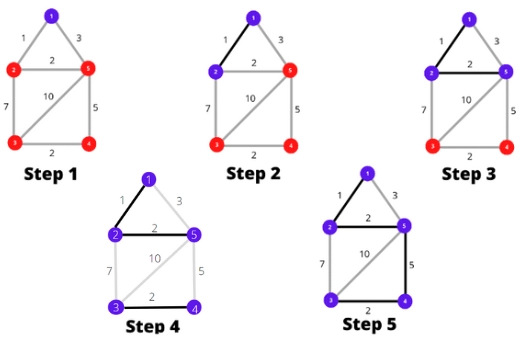
- Kruskal:先sort边集,然后降序用并查集对边(a,b)判环,加入容器,最终即可产生生成树
- 
```cpp
// 假设已有并查集代码find和union
struct edge {
int u, v, w;
}
int n;
vector<edge> e, tree;
bool cmp(const edge & e1, const edge & e2) {
return e1.w < e2.w;
}
void Kruskal() {
sort(e.begin(), e.end(), cmp);
for (int i = 0; i < e.size(); i++) {
if (find(e.u) != find(e.v)) {
union(e.u, e.v);
tree.push_back(e);
}
if (minTree.size() >= n) break;
}
}
```
## 连通性
- 割点和割边
- 使用Tarjan算法:
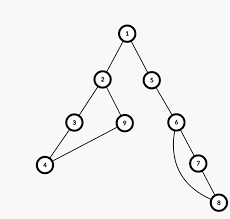
- dfs形成一棵搜索树
- 使用`dfn`记录每个节点的dfs序
- 使用`low`记录dfs树上该节点及其后代节点能连接到的最小dfs序
- 
- 割点
- 若根节点的孩子不止一个,根节点必为割点
- 若孩子不止一个的根节点或任意非根节点`u`和其子节点`v`间存在关系`low[v]>=dfn[u]`,`u`是割点;
- 割边
- 若任意节点`u`和其子节点`v`间存在关系`low[v]>dfn[u]`,则边`(u,v)`是割边
- 如果割边的任一端点还连接其它边,则它一定是割点;只要一个连通图不是$K_2$,有割边就一定有割点,没有割点就一定没有割边;
```cpp
// 代码是割点,只要把触发改成low[v]>dfn[u],去掉根特判,再稍微修改存储结构就是割边
int n, m;
vector<int> G[MAXN];
int dfs_idx=0, dfn[MAXN], low[MAXN];
set<int> cuts;
void tarjan(int u, int fa, int root) {
dfn[u] = low[u] = ++dfs_idx;
int n_child = 0; // n_child是搜索树的后代个数,注意和邻接表长度不同
for(int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (!dfn[v]) {
n_child++;
tarjan(v, u, root);
low[u] = min(low[u], low[v]);
if (u != root && low[v] >= dfn[u]) { // 根特判
cuts.insert(u);
}
} else if (v != fa) {
low[u] = min(low[u], dfn[v]);
}
}
// 根特判
if (u == root && n_child >= 2) {
cuts.insert(u);
}
}
void solve() {
dfs_idx = 0;
cuts.clear();
memset(dfn, 0, sizeof(dfn));
for(int i = 1; i <= n; i++)
if (!dfn[i]) tarjan(i, -1, i);
}
```
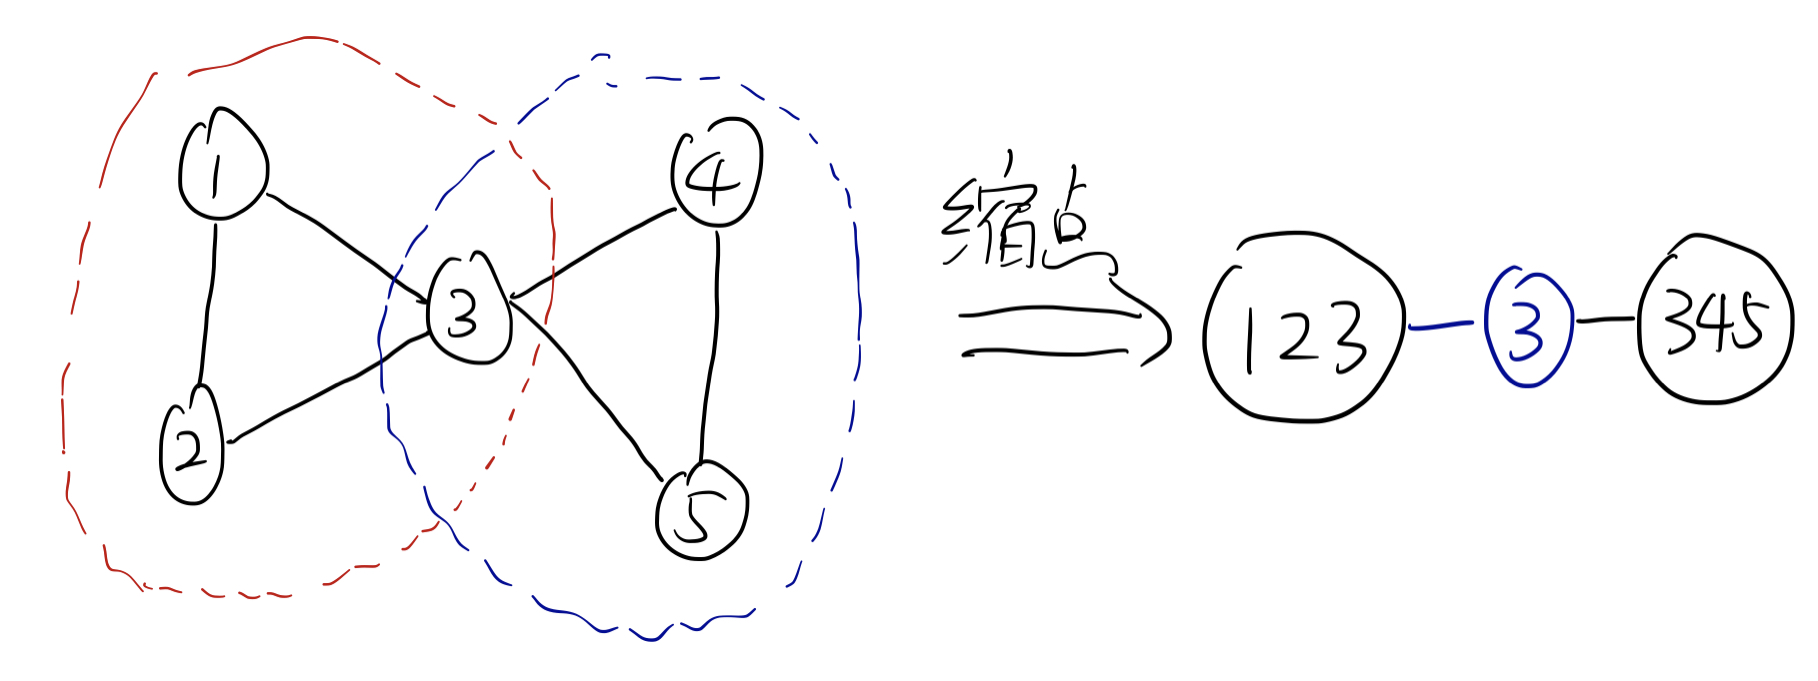
- 点双连通分量(BCC)
- 不存在任何割点,任意两点间都存在点不重复的路径(除两端点)
- 利用求割点的方法,借助一个栈实现:
- 在搜索时将节点按dfn入栈
- 一旦发现任意节点(含根节点)$u$和其子节点`v`间存在关系`low[v]<=dfn[u]`,就出栈直到$u$处于栈顶
- 此时找到一个点双连通分量:$\mathcal{G}[u \cup 出栈节点]$
- $u$存在于多个分量中,因此不出栈,算法继续
- 若$u$非根节点,则$u$上触发的出栈次数+1,就是$u$割出的点双连通分量数
- 若$u$为根节点,则$u$上触发的出栈次数(不+1)恰好为$u$的孩子数。若$u$不止一个孩子,则其还等于$u$割出的点双连通分量数,否则$u$不是割点。
- 从图上任意一点到另一点的无权最短路径经过的割点,是两点间路径上的必经点。使用“点双缩点”技巧可以加速计算:
- 
```cpp
int n, m;
vector<int> G[MAXN];
int dfs_idx=0, dfn[MAXN], low[MAXN];
bool instk[MAXN];
stack<int> stk;
vector<set<int> > bcc; // 处理重边的影响,用set
int tarjan(int u, int fa, int root) {
dfn[u] = low[u] = dfs_idx++;
stk.push(u);
instk[u] = true;
int n_child = 0;
for(int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (!dfn[v]) {
n_child++;
tarjan(v, u, root);
low[u] = min(low[u], low[v]);
if (low[v] >= dfn[u]) { // 对于点双,根的性质和非根一样
set<int> new_bcc;
do {
int x = stk.top();
stk.pop();
instk[x] = false;
new_bcc.insert(x);
if (x == v) break; // 注意不能出到u,也不能用栈顶是u来判断
} while(true);
new_bcc.insert(u);
bcc.push_back(new_bcc);
}
} else if (v!=fa) {
low[u] = min(low[u], dfn[v]);
}
}
return n_child; // 在外围处理单点成连通分量的情况
}
void solve() {
dfs_idx = 0;
bcc.clear();
memset(dfn, 0, sizeof(dfn));
for(int i = 1; i <= n; i++)
if (!dfn[i]) {
// 清理栈
while(!stk.empty()) stk.pop();
if(tarjan(i, -1, i) == 0) {
// 单点成为一个分量
set<int> new_bcc;
new_bcc.insert(i);
bcc.push_back(new_bcc);
// 注:这是只有点双需要的操作,因为边双和强都会在dfn=low时自动出栈
}
}
}
```
- 边双连通分量
- 不存在任何割边,任意两点间都存在边不重复的路径
- 若对节点$u$,其所有后代节点$v$都不存在关系`low[v]<dfn[u]`,则其和所有后代构成一个边双连通分量。若其有父节点,其和父节点间的边一定是割边。
- 依然利用栈实现:
- 在搜索时将节点按dfn入栈
- 遍历节点$u$的**所有子节点**后,如果依然有`low[u]==dfn[u]`,此时连同$u$一起出栈
- 找到一个边双连通分量:$\mathcal{G}[出栈节点]$,$u\in出栈节点$
- 【性质】对于一个连通图$\mathcal{G}$,其边双连通分量构成多个岛,每个岛间的连接构成一棵树。若要添加一些边,使$\mathcal{G}$整个成为边双连通的,只需计算岛连接构成的树上度为1的节点个数`n_1`,需要添加的最少边数为`(n_1+1)/2`
- 实现时先将每个岛上的所有点合并,然后构建树形结构,再计算度为1的节点数
- 
- 对非连通图,先选定一个节点,将其连接到所有其它连通分量。然后按连通图的公式计算即可。
```cpp
int n, m;
vector<int> G[MAXN];
int dfs_idx=0, dfn[MAXN], low[MAXN], n_bcc=0, bcc[MAXN]={0};
bool instk[MAXN];
stack<int> stk;
void tarjan(int u, int fa) {
// 初始化本节点
dfn[u] = low[u] = ++dfs_idx;
stk.push(u);
instk[u] = true;
// 处理后代节点(注意屏蔽fa)
for (int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (!dfn[v]) {
tarjan(v, u);
low[u] = min(low[u], low[v]);
} else if (instk[v] && v!=fa) {
low[u] = min(low[u], dfn[v]);
}
}
// 如果找到边双连通分量
if (dfn[u] == low[u]) {
n_bcc++;
do {
int x = stk.top();
stk.pop();
instk[x] = false;
bcc[x] = n_bcc;
if (x == u) break;
} while (true);
}
}
void solve() {
n_bcc = dfs_idx = 0;
memset(dfn, 0, sizeof(dfn));
for(int i = 1; i <= n; i++)
if (!dfn[i])
tarjan(i, -1);
vector<int> bccs[n_bcc + 1]; // 注意n_bcc从1开始
for(int i = 1; i <= n; i++) { // 收纳
bccs[bcc[i]].push_back(i);
}
}
```
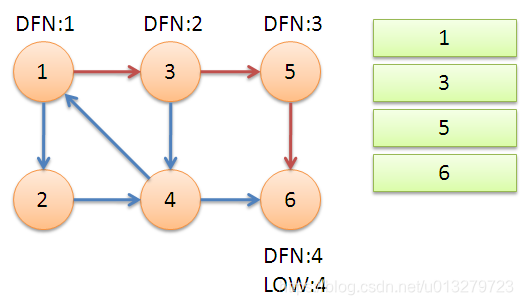
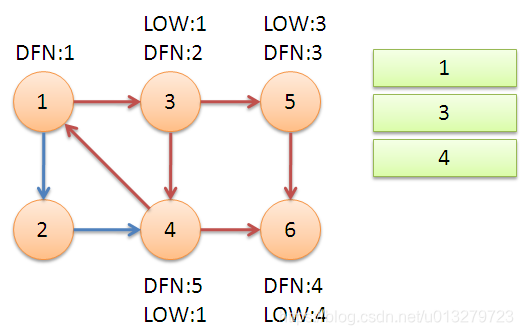
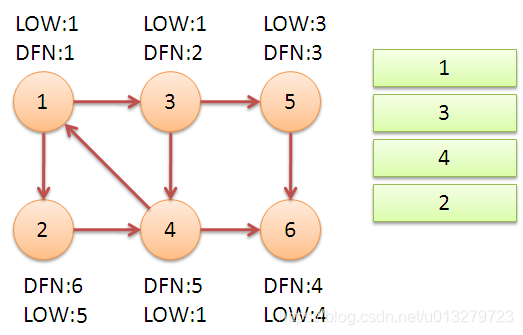
- 强连通分量
- 每个点都有回路
- 同样基于Tarjan算法:
- 在搜索时将节点按dfn入栈
- 遍历节点$u$的所有子节点后,如果依然有`low[u]==dfn[u]`,此时连同$u$一起出栈
- 找到一个强连通分量:$\mathcal{G}[出栈节点]$,$u\in出栈节点$
- 与双连通的区别与联系:
- 强连通和边双连通流程几乎一样;
- 双连通中回到父节点的边是不做处理的(如果不是重边的话),强连通中则视为一条回退边(对应无向图有二重边的情况)。
- 注意:不管是双连通还是强连通,在计算时一定考虑原图本身就不连通的情况,这时应该使用dfn标记来确定是否需要遍历每个节点做Tarjan;极端情况下只有一个点,这时它必须单独成为一个连通分量(不管是什么类型的连通)
- 
```cpp
int n, m;
vector<int> G[MAXN];
int dfs_idx=0, dfn[MAXN], low[MAXN], n_scc=0, scc[MAXN]={0};
bool instk[MAXN];
stack<int> stk;
void tarjan(int u) {
// 初始化本节点
dfn[u] = low[u] = ++dfs_idx;
stk.push(u);
instk[u] = true;
// 处理后代节点
for (int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (!dfn[v]) {
tarjan(v);
low[u] = min(low[u], low[v]);
} else if (instk[v]) {
low[u] = min(low[u], dfn[v]);
}
}
// 如果找到强连通分量
if (dfn[u] == low[u]) {
n_scc++; // n_scc从1开始,scc[x]记录x属于哪个scc
do {
int x = stk.top();
stk.pop();
instk[x] = false;
scc[x] = n_scc;
if (x == u) break;
} while (true);
}
}
void solve() {
n_scc = dfs_idx = 0;
memset(dfn, 0, sizeof(dfn));
for(int i = 1; i <= n; i++)
if (!dfn[i])
tarjan(i);
}
```
缩点例题(洛谷P3387):
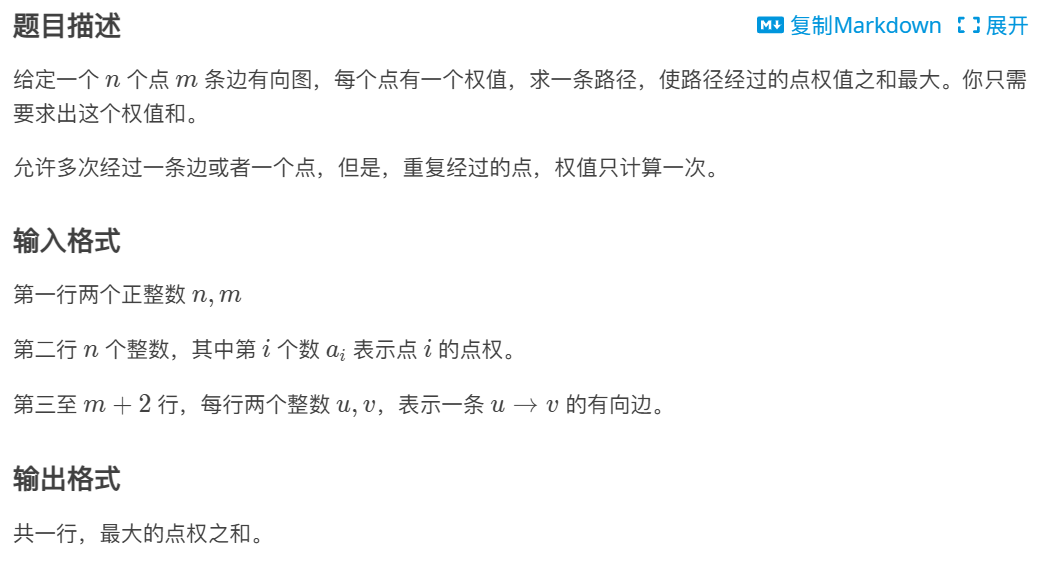
每个强连通分量里可以随便走来走去,但是通过有向桥进入别的连通分量就回不去了,因此将每个强连通分量缩为1个节点,各个强连通分量之间保留原先存在的一条有向边;此时必然构成一个DAG,使用DFS解决动态规划问题
$$
f_i=\begin{cases}\max (f_j+a_i), &i\rightarrow j\\ a_i, &\nexists j\end{cases}
$$
然后找到$\max f_i$即可
```cpp
#include<bits/stdc++.h>
#define ll long long
#define MAXN 100005
#define INF 0x7FFFFFFF
using namespace std;
int n, m, n_scc=0, dfsx=0;
int dfn[MAXN], low[MAXN], scc[MAXN];
int a[MAXN], scc_a[MAXN];
stack<int> stk; bool instk[MAXN];
vector<int> G[MAXN];
set<int> G2[MAXN]; // 由于要去重所以用set
ll scc_sum[MAXN];
void tarjan(int u) {
dfn[u] = low[u] = dfsx++;
instk[u] = true;
stk.push(u);
for (int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (!dfn[v]) {
tarjan(v);
low[u] = min(low[u], low[v]);
} else if (instk[v]) {
low[u] = min(low[u], dfn[v]);
}
}
if (low[u] == dfn[u]) {
n_scc++;
do {
int x = stk.top();
stk.pop();
instk[x] = false;
scc[x] = n_scc;
scc_a[n_scc] += a[x];
if (x == u) break;
} while(true);
}
}
void dfs_sum(int s) {
if (scc_sum[s] != -1) return;
scc_sum[s] = scc_a[s];
for(set<int>::iterator ite = G2[s].begin(); ite != G2[s].end(); ite++) {
dfs_sum(*ite);
scc_sum[s] = max(scc_sum[*ite] + (ll)(scc_a[s]), scc_sum[s]);
}
}
void solve() {
for(int i = 1; i <= n; i++) {
if (!dfn[i]) tarjan(i);
}
// 缩点,每个连通分量视为一个点
// 遍历原图,在原边两端点对应的两分量间建边
for(int u = 1; u <= n; u++) {
for(int i = 0; i < G[u].size(); i++) {
int v = G[u][i];
if (scc[u] != scc[v]) // 注意自环
G2[scc[u]].insert(scc[v]);
}
}
// 直接dfs找最大
ll max_sum = -INF;
memset(scc_sum, -1, sizeof(scc_sum));
for(int s = 1; s <= n_scc; s++) {
if (scc_sum[s] == -1)
dfs_sum(s);
max_sum = max(scc_sum[s], max_sum);
}
cout << max_sum << endl;
}
int main() {
cin >> n >> m;
for(int i = 1; i <= n; i++)
cin >> a[i];
for(int i = 0; i < m; i++) {
int u, v;
cin >> u >> v;
G[u].push_back(v);
}
solve();
}
```
## 网络流
- 最大流
- FF-EK:
- 使用无权BFS找到源点到汇点的一条增广路,将路上的边减去路上的最大流量,把镜像的逆流边加入残差图中
- 不断重复,直到不能找到增广路为止,此时从源点已流出的流量(或者汇点出发的逆流量)就是网络的最大流
- Dinic:
- 同样使用残差图和逆流边的思路,但每次寻找增广路时先进行BFS分层,流量只能在层间流动
- 最小割
- 最大流算法完成后,从源点依然可达的点成为一个割集$\mathcal{S}$,而不在$\mathcal{S}$中的点一定是可达汇点的点,记为$\mathcal{T}$。$\mathcal{S}$和$\mathcal{T}$就是网络的一个最小割,并且:最大流量就是最小割代价
```cpp
/** EK模板 **/
int n, m, A[N][N], pre[N], flow[N]; // flow[n]是源点到n为止能流的流量
int bfs(int s, int t) {
memset(pre, -1, sizeof(pre)); //BFS最短路上一跳,类似Dijkstra
pre[s] = -2; // 避免把源点视为未访问
flow[s] = inf; //假设源点流量为无穷
queue<int>q; q.push(s); // BFS
while (!q.empty()) {
int u = q.front(); q.pop();
// 遍历邻接矩阵,找到未使用的边,并维护流量
for (int v = 1; v <= n; v++) {
if (A[u][v] > 0 && pre[v] == -1) {
pre[v] = u;
flow[v] = min(flow[u], A[u][v]); //当前的流量是边权的最小值
q.push(v);
}
}
}
return pre[t] == -1 ? -1 : flow[t]; // 能走到t,返回t时的流量,否则-1
}
int EK(int s, int t) {
int ans = 0;
while (1) {
int d = bfs(s, t);
if (d == -1) break; //无法找到増广路
ans += d; // 不断加入流量
int x = t, p;
while (x != s) { //遍历t→s路径,更新逆流边
p = pre[x];
A[p][x] -= d; // 原始容量减少
A[x][p] += d; // 逆流容量增加
x = p;
}
}
return ans;
}
```
- x最小费用最大流(需要用到SPFA)
## 匹配、独立集、覆盖
- 基本概念:
- **点独立集**:选择一个点集的导出子图,其中任何点都不相连
- 最大独立集:取到最多点的独立集
- $|最大独立集|=|V|-|最大匹配|$
- **匹配**(边独立集):选择一个边集的生成子图,其中节点两两配对,每个节点只有和对应节点的一条边,没有其他边;也就是线图为独立集
- 最大匹配:取到最多边的匹配
- 最大带权匹配:取到最大权值的匹配
- 完美匹配:最大,且包含所有节点
- **点覆盖集**:选择一个节点集(不是子图),使原图所有的边都至少有一端在该集合里
- 最小点覆盖:取到最少点的覆盖集
- $最小点覆盖\Leftrightarrow 最大匹配$
- **边覆盖集**:选择一个边集的生成子图,使原图所有点都至少连接一条边
- 最小边覆盖:取到最少边的覆盖集;完美匹配一定是最小边覆盖
- 二分图匹配
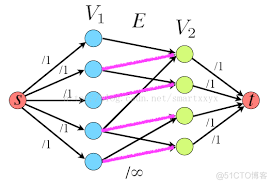
- 通过给二分图两侧添加源点和汇点,将各条边权都视为1,用最大流即可实现最大匹配
- 
- 匈牙利算法
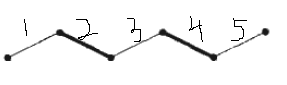
- 存在交错增广路径的匹配,一定有边数多1的对应匹配,如图所示,2、4是现有的匹配,1、3、5是可以对应到的边数多1的匹配:
- 
- 匈牙利算法初始时从图的一侧的首个元素开始,将第一条边加入匹配
- 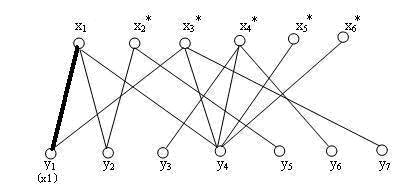
- 然后对同一侧的每个元素,依次尝试将其每条边加入匹配。
- 
- 如果某条边与之前的边冲突,先不急着尝试下一条边,而是递归地询问有冲突的那条边对应的同侧元素,是否可以保证它在匹配里,但是更换另一条边;递归实在没有结果,再尝试对当前元素询问下一条边,如x3想要匹配y1,此时询问x1是否可以更换其他边;于是x1想要匹配y2,询问x2是否可以更换其它边;直到x2匹配了y5
- 
- x3-y1-x1-y2-x2-y5,显然是一条增广路
```cpp
int n, m, G[MAXN][MAXN], match[MAXN], book[MAXN];
bool dfs(int x) {
for(int i = 1; i <= m; i++) { // 遍历异类
if (G[x][i] && !book[i]) { // 必须有边且未标记
book[i] = 1; // 标记目标,要求前面的同类更换匹配
if (!match[i] || dfs(match[i])) { // 如果已被匹配,尝试让同类更换
match[i] = x; // 自己匹配该异类目标,增广成功
return true;
}
}
}
return false; // 没有找到可用的目标
}
int hung() {
int ans = 0;
for(int i = 1; i <= n; i++) {
memset(book, 0, sizeof(book));
if (dfs(i)) ans++;
}
return ans;
}
```
- x二分图最大权匹配(KM算法)
- x路径覆盖
## 其它
- x着色问题
- x2-SAT
- 每个析取式都含有2个变量的合取范式:如$(A\lor\lnot B)\land(A\lor B)$,含义为“要么A要么非B,且要么A要么B”
- 2个域的多域并查集问题是2-SAT的特例
- x最大团
- 稳定婚配
- 类似无权匈牙利算法,但更换匹配目标时有优先级
- x树链剖分
![]()