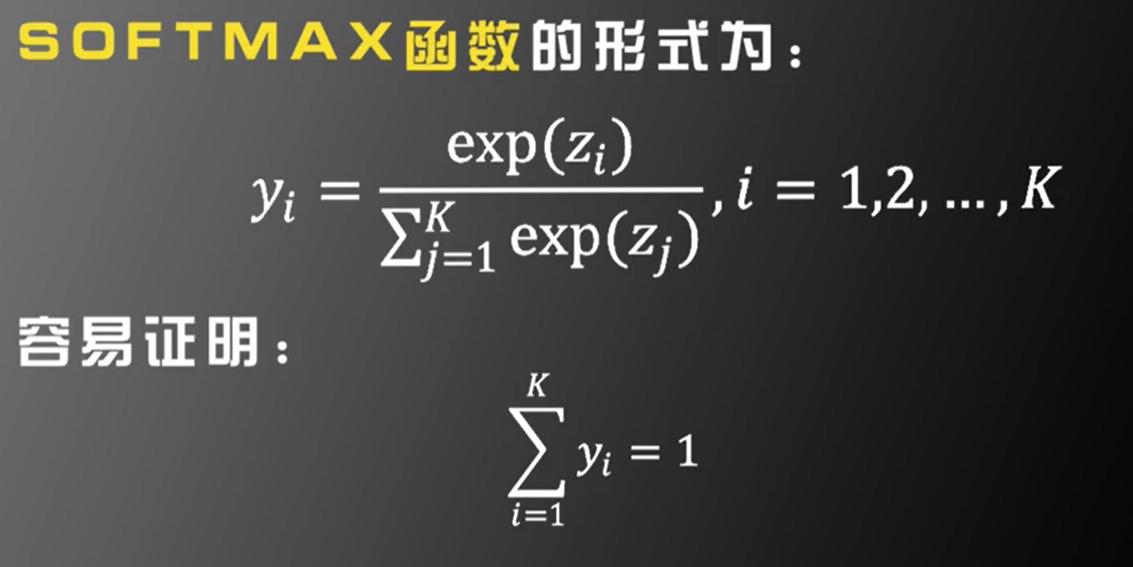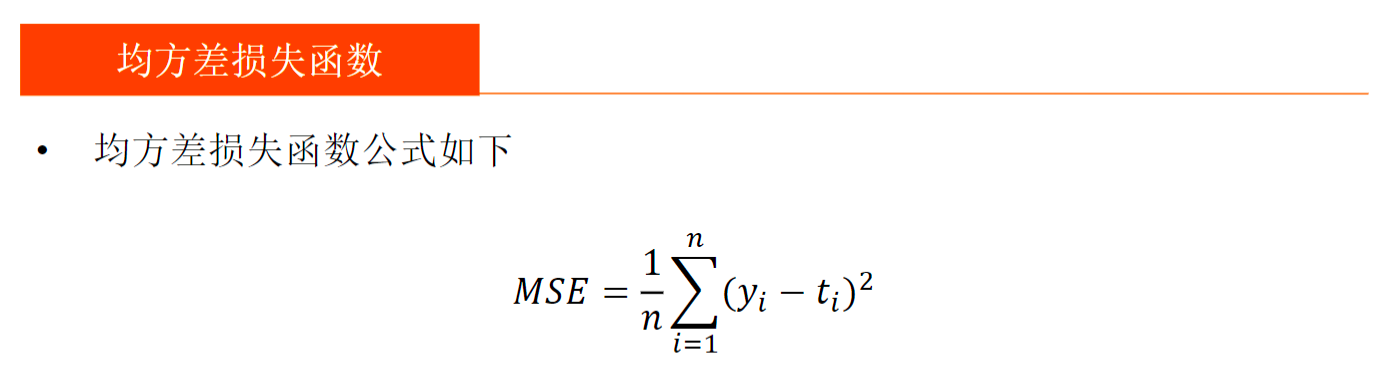博客 > 人工智能&数据科学 > 通用算法和模型 > 神经网络
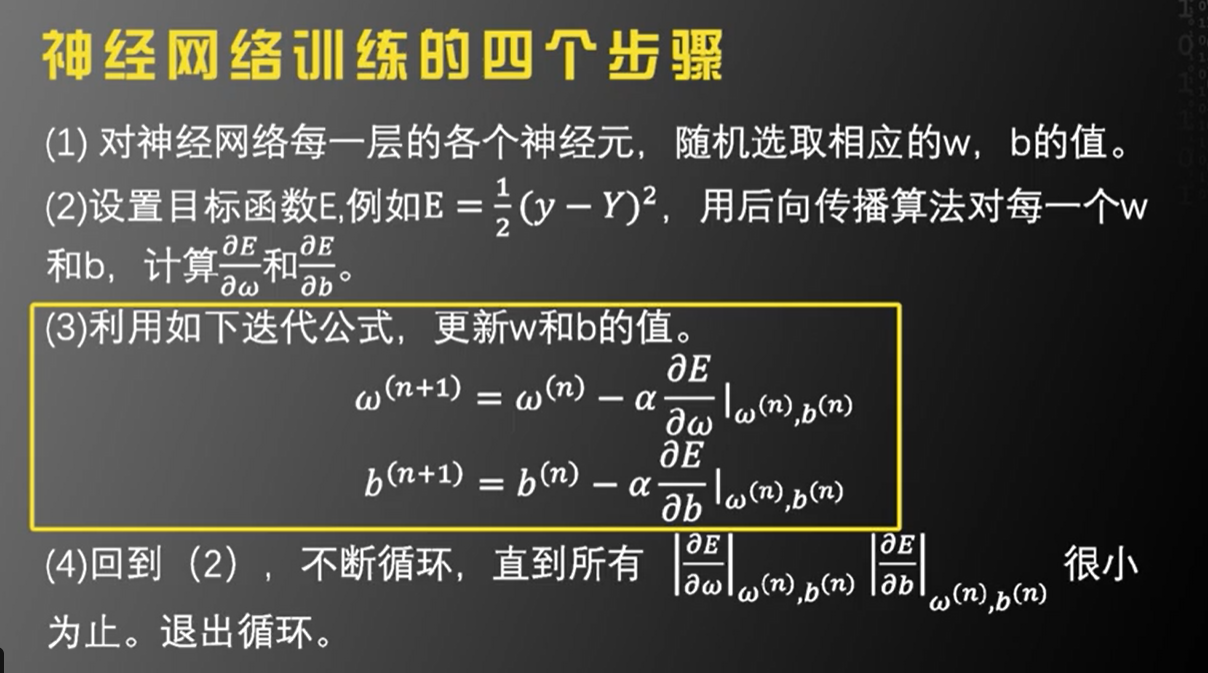
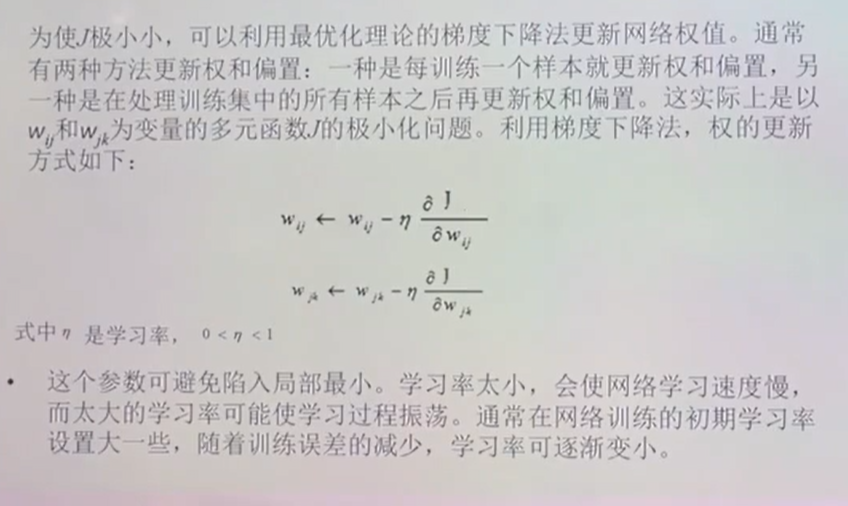
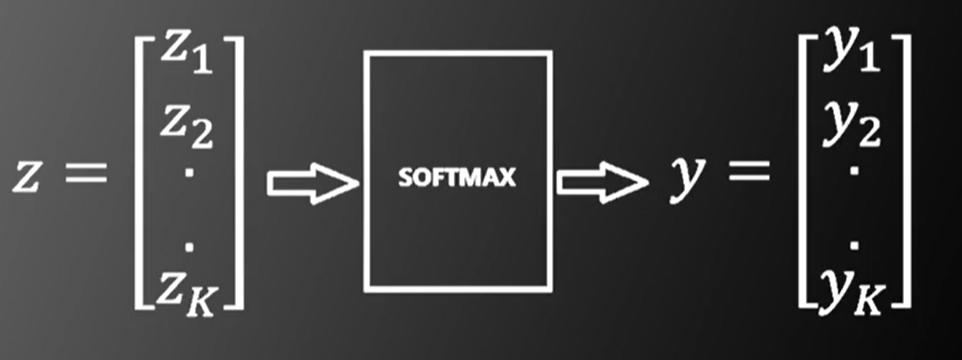
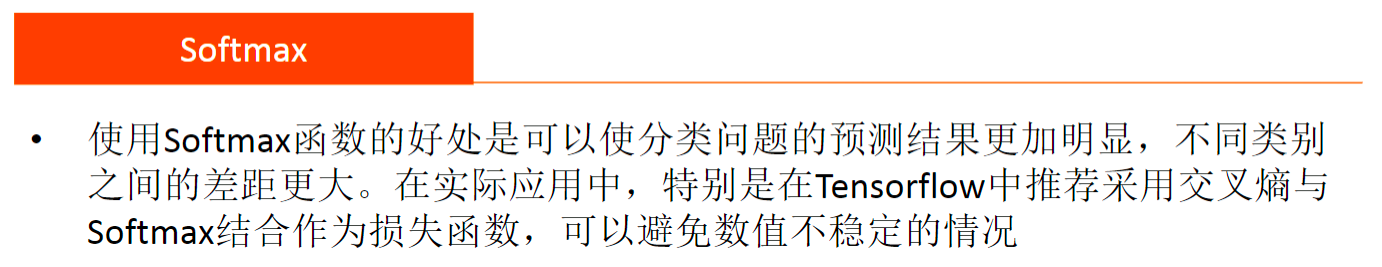
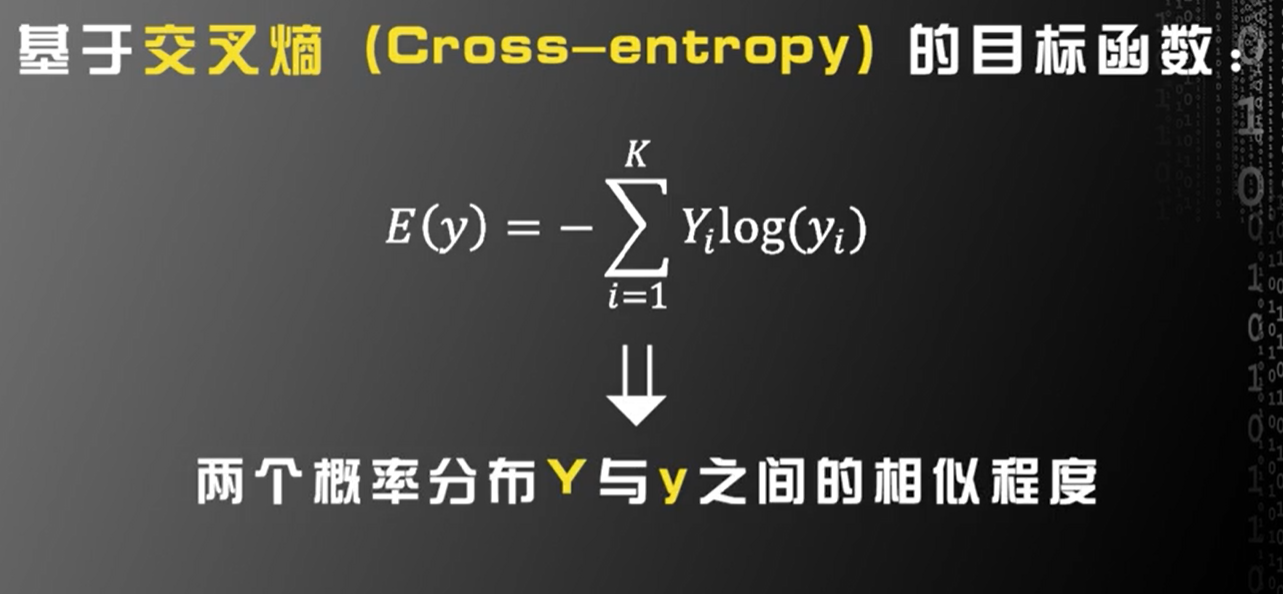
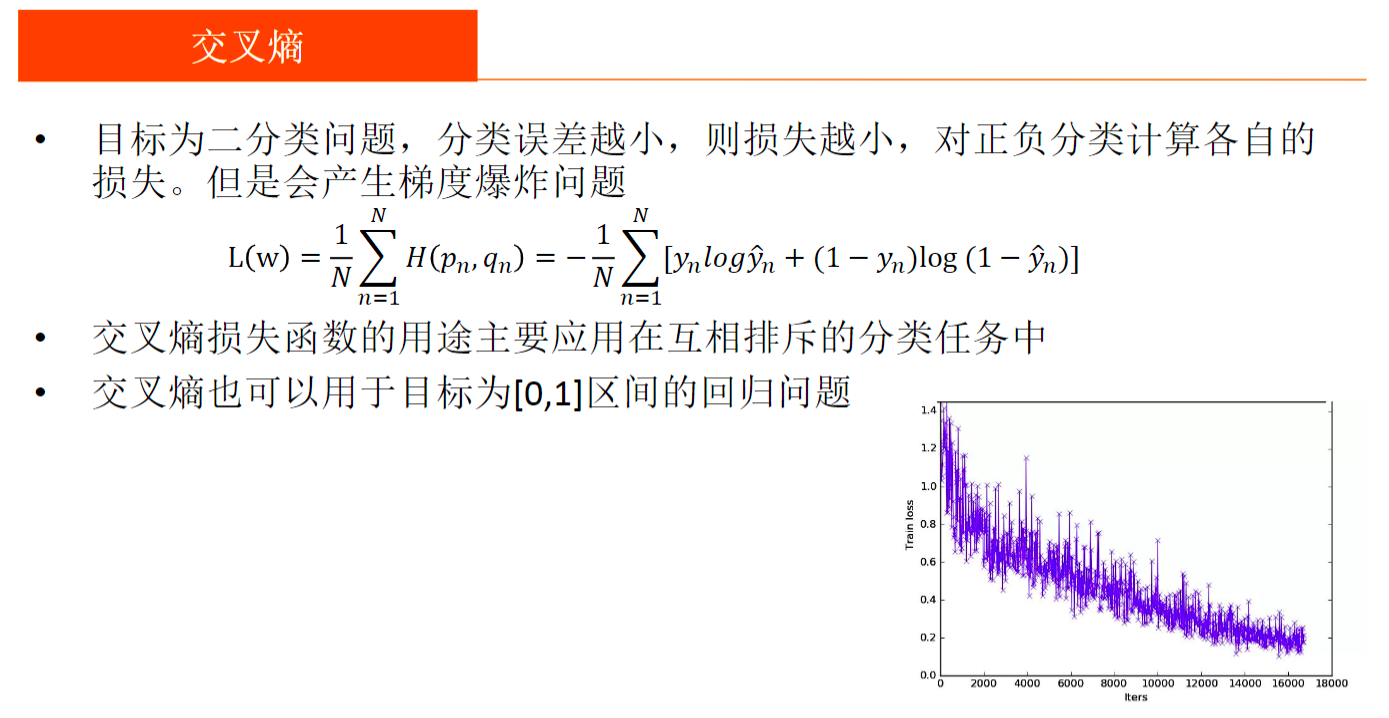
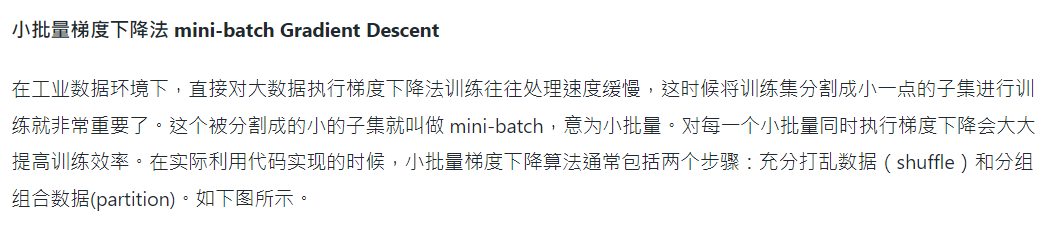
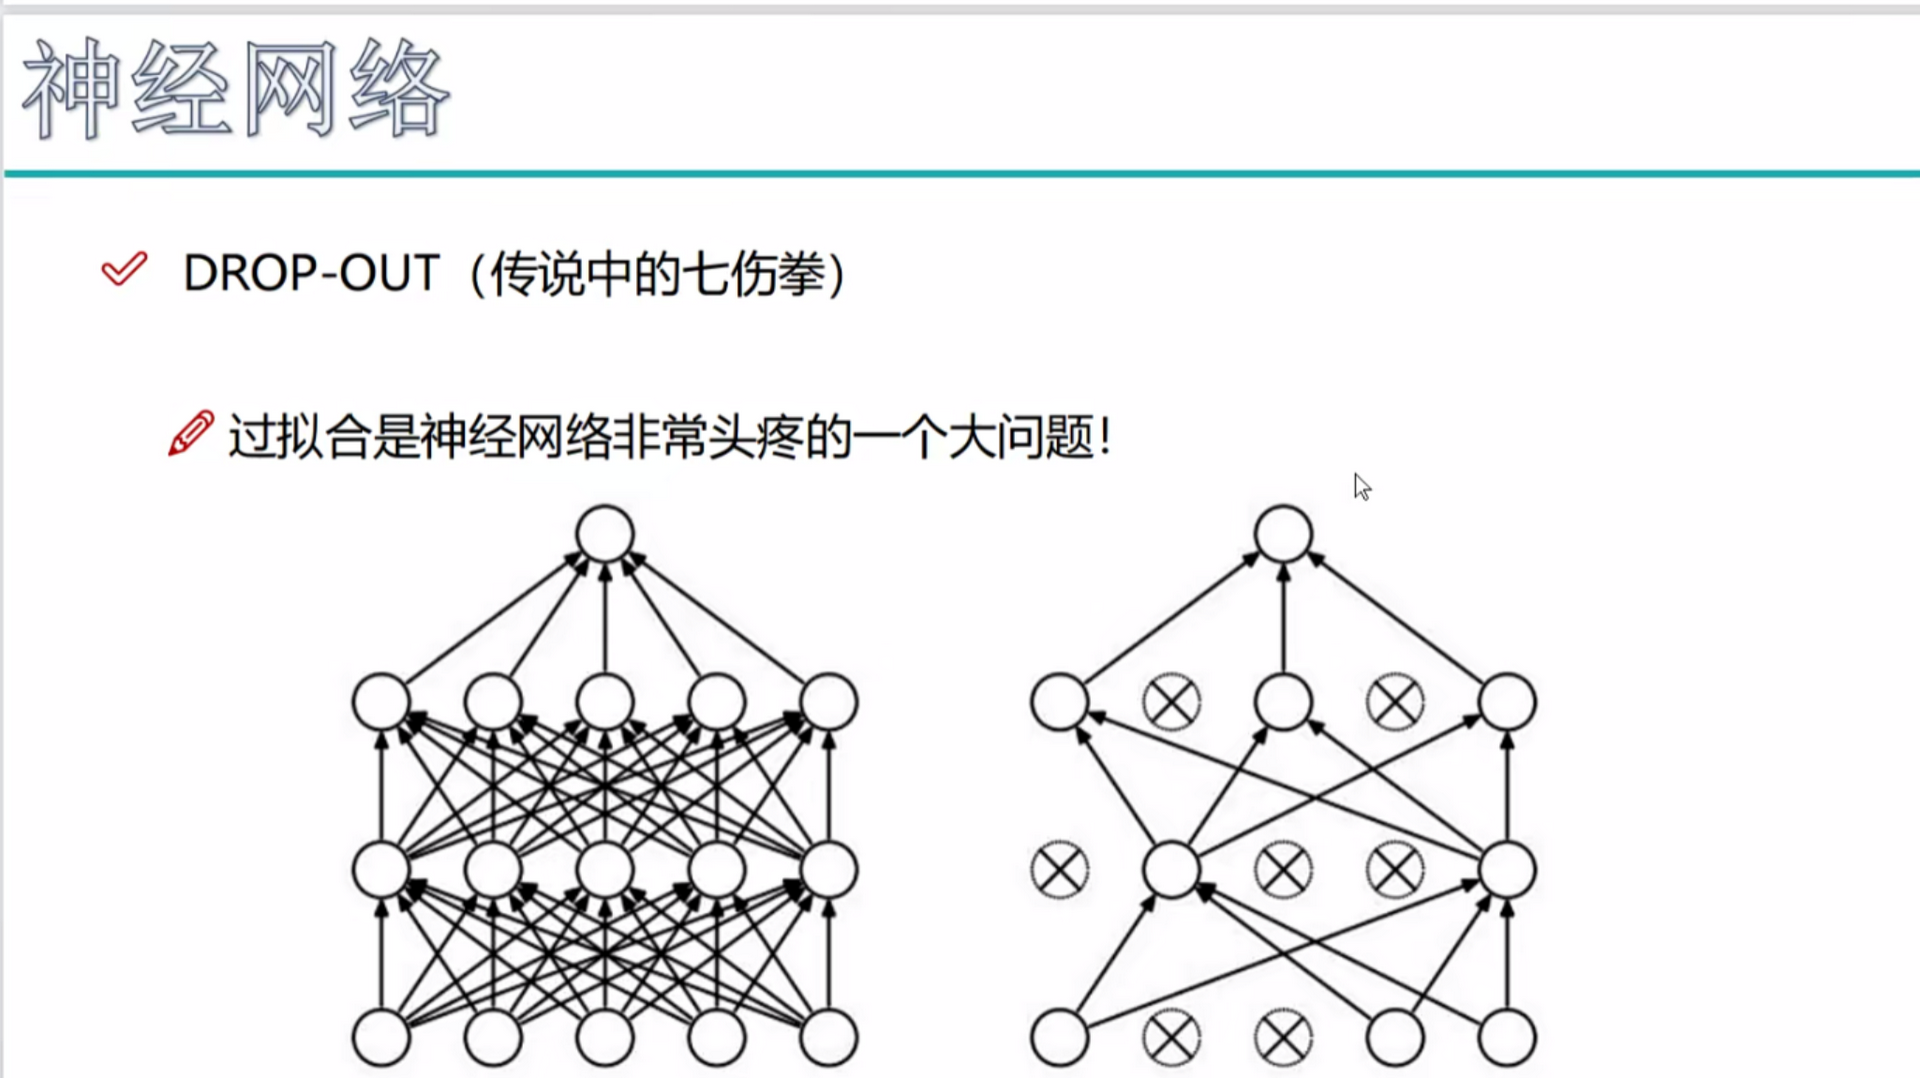
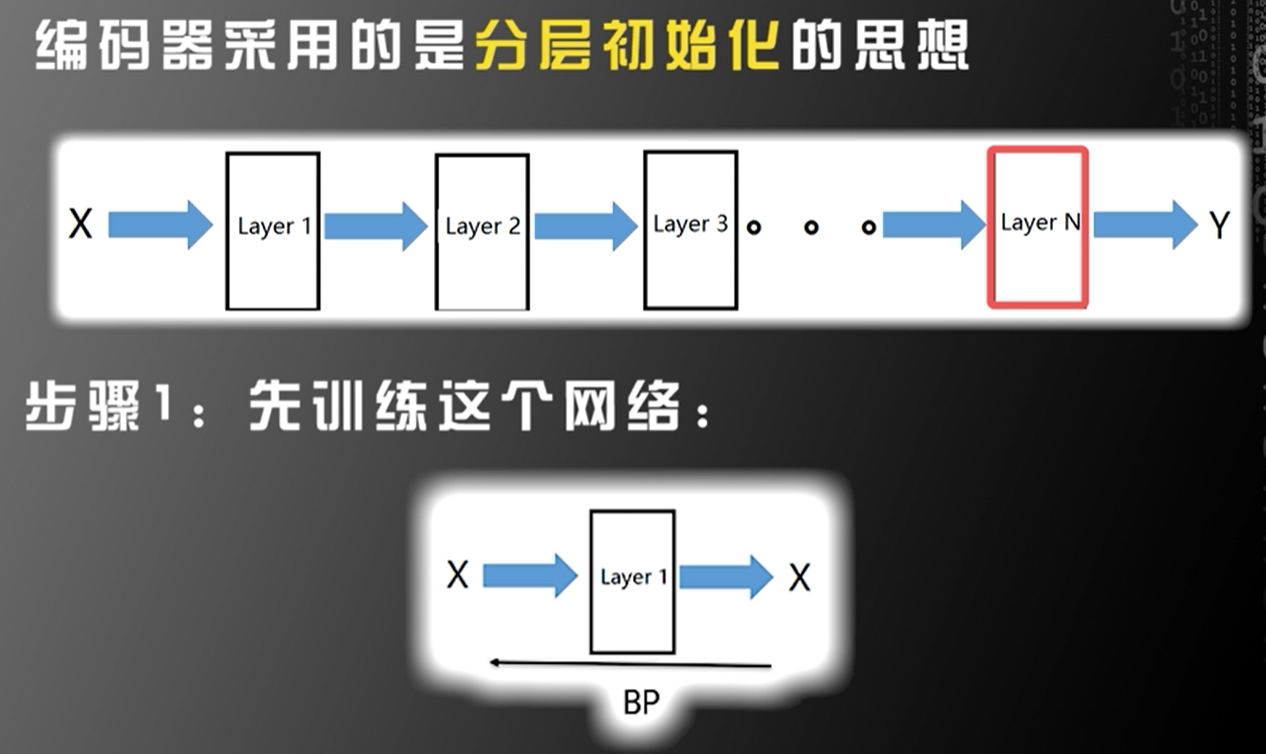
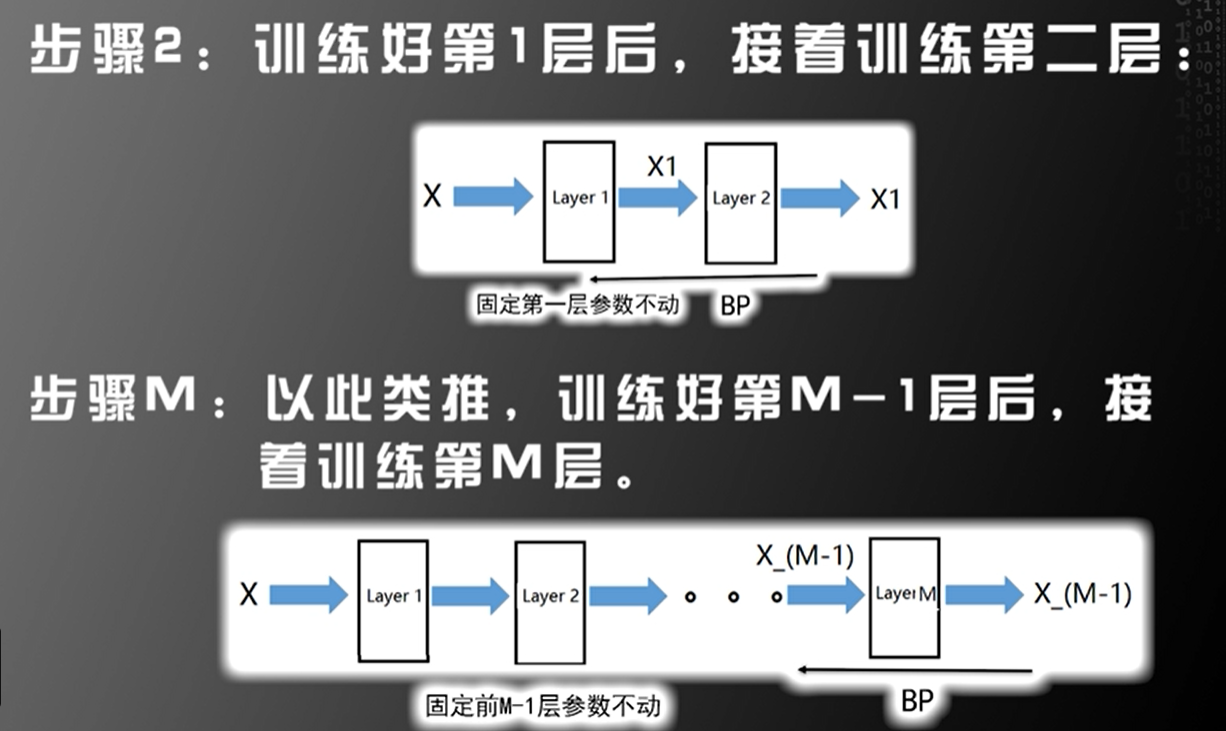
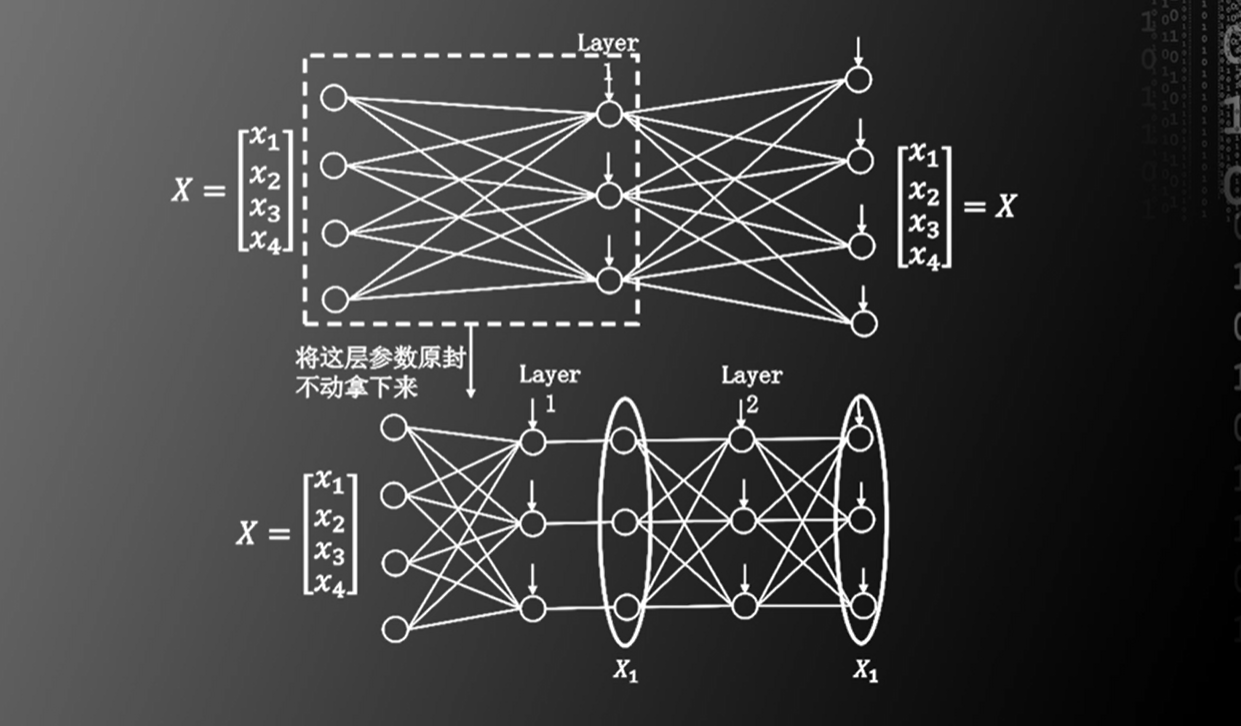
# 反向传播(Back Propagate, BP)神经网络 反向传播(误差反向传播)是常用于前馈神经网络中以实现各层参数(主要是每个节点的入弧的权$W$(Omega)和节点本身的偏置值$b$)机器学习的一种算法。 其实质是利用特殊节点,用链式求导法则优化的一种梯度下降算法。原始的梯度下降需要将每一个参数的梯度(导数)单独计算,而反向传播利用链式求导法则实现了简化 ![f8a6d85f7ad7314766f0e24c64c56c09.png](/resources/fc9ea65b25444267868c60c87fd508cd) > 梯度下降法基础知识(上图的$\alpha$或下图的$\eta$为学习率): > ![64767533db884c889e65a3aebee4d50f.png](/resources/7998c7ec26ef49f4b9ca5e9107218ef4) ## 优化措施 ### 动量(Momentum)矫正 给梯度下降方向添加一个另外的偏向力,以避免梯度下降法陷入一个不靠谱的局部极小值 ## SoftMax 常用于分类任务,可以使其中较大的项取得更大的值,并保证所有输出分量加和为1 ![23a4a27f0b3d8d9cb3a9f9dd846662eb.png](/resources/4160540fd3a0421c8443c5d392eb80d2) ![e0b97c54f5c5adf2dc5ff36118755b7a.png](/resources/d2c86d29341c4b3595af04558302af7b) ![db133bd7dad59d16bbaedc2878f9e324.png](/resources/ba30174630e343d7a9dd177b344999ff) ### 使用优化的目标函数(损失函数/代价函数) ![196b5c9a7c875b6e17bcbc507a34e325.png](/resources/66fe5bd7fd3140ce8dfb554c4c6fdc41) https://blog.csdn.net/weixin_36811328/article/details/83451096 交叉熵(Cross Entropy): ![2e8a50baa2164f98e52620d5b87f6a7f.png](/resources/202e819aa7c94dfe8a7d8139c0da96f9) ![07ad0ae3716bf677f417bfa89d9a91a6.png](/resources/a06b72fff59446cea39970cfc63048f7) ### 随机梯度下降法(SGD) ![7590e9d75cdc088f5436c1f122549321.png](/resources/68400263abdf4abcae957eebaca90cfc) ![eea3f5df7f6db57358222aa722ce75bf.png](/resources/d644a2f9631a45c0b92c29b8c69d274b) ![325107ce9d9079d2491058e8b44528ba.png](/resources/017db6effd0f43edbffaadd00932e4f8) ### drop-out训练机制 ![4400f518a657df264055f6846dc3eff1.png](/resources/5eeaf32dd81941d8945645cfc9937797) ### 自编码器 分层将训练样本本身训练至网络的每一层中,以此来避免纯粹随机初始化网络参数时出现的梯度下降法取到过于不靠谱的极小值的问题。 ![64da750001be3cd9139bf2c82512c16c.png](/resources/a971b5be6e004103a09920fa5ceb5fac) ![5c5827e66a936cd31e7be40d786a0a6c.png](/resources/bc460a2a1e67483c88eb6f7b110c59b3) ![2b9b7ab776fbbd003186b95a4760ecf1.png](/resources/cc97b9e7db454e1a82683ee941fff943) ## 其他优化技术 - 模拟退火 - Bagging - 遗传算法