# LLM辅助学习
## 1. 引言
### 1.1 深度学习简介
深度学习是机器学习的一个子领域,主要基于人工神经网络,尤其是多层神经网络(Deep Neural Networks, DNN)。通过构建多层的神经网络模型,深度学习在图像识别、自然语言处理、语音识别等领域取得了突破性进展。
- **深度学习的历史背景**:深度学习的发展可以追溯到20世纪80年代,但由于计算资源的限制,实际应用受限。2006年,Geoffrey Hinton等人提出了逐层预训练的方法,使深度神经网络在处理大规模数据时表现出色,开启了深度学习的新时代。
- **深度学习的基本概念**:深度学习通过构建多层的神经网络来提取数据的特征,进行模式识别和预测。它依赖于大规模的数据和强大的计算资源,常用的框架包括TensorFlow、PyTorch等。
### 1.2 机器学习和深度学习的区别
- **机器学习**:机器学习是一种使计算机从数据中学习模式和规律的技术。它包括监督学习、无监督学习和强化学习等方法。常见的机器学习算法有线性回归、决策树、支持向量机等。
- **深度学习**:深度学习是机器学习的一个子集,主要基于人工神经网络,特别是多层神经网络。与传统机器学习方法相比,深度学习在处理复杂数据(如图像、语音、文本)时表现出色。
主要区别在于:
1. **数据需求**:深度学习通常需要大量的数据进行训练,而传统机器学习方法在小规模数据集上也能表现良好。
2. **特征工程**:深度学习能够自动提取特征,而传统机器学习方法需要人工设计特征。
3. **计算资源**:深度学习需要强大的计算资源,通常需要GPU加速。
### 1.3 自然语言处理(NLP)概述
自然语言处理是计算机科学的一个重要分支,旨在使计算机理解、解释和生成人类语言。NLP结合了计算语言学和人工智能的技术,应用广泛,如机器翻译、情感分析、问答系统等。
- **NLP的基本任务**:包括语言模型、词法分析、句法分析、语义分析等。常见的NLP任务有分词、词性标注、命名实体识别、情感分析等。
- **NLP的方法**:从传统的基于规则的方法,到统计学习方法,再到如今的深度学习方法,NLP技术不断发展。目前,基于神经网络的模型,如RNN、LSTM、Transformer等,在NLP领域取得了显著的进展。
## 2. 神经网络基础
### 2.1 人工神经网络(ANN)
人工神经网络是受生物神经系统启发而设计的计算模型。基本的神经网络由输入层、隐藏层和输出层组成。
- **神经元**:神经网络的基本单元。每个神经元接收来自前一层的输入,进行加权求和后,通过激活函数生成输出。
- **层**:神经网络的结构由多个层组成。输入层负责接收输入信号,隐藏层进行特征提取和变换,输出层生成预测结果。
- **权重和偏置**:连接神经元的边上有权重���每个神经元还有一个偏置。权重和偏置是神经网络学习的参数,通过训练数据进行调整。
### 2.2 前向传播与反向传播
前向传播和反向传播是神经网络训练的核心过程。
- **前向传播**:输入数据经过各层神经元的计算,最终在输出层生成预测结果。前向传播过程中,输入信号逐层传递,并通过激活函数进行非线性变换。
- **反向传播**:计算预测结果与真实标签的误差,通过梯度下降法调整权重和偏置。反向传播使用链式法则计算每层参数的梯度,并根据梯度更新参数以减少误差。
数学表达:
- 前向传播:$a^{(l)} = \sigma(W^{(l)}a^{(l-1)} + b^{(l)})$
- 反向传播:利用损失函数 $L$ 计算梯度:$\frac{\partial L}{\partial W^{(l)}}$ 和 $\frac{\partial L}{\partial b^{(l)}}$
### 2.3 激活函数
激活函数引入非线性,使神经网络能够拟合复杂的函数关系。常见的激活函数有:
- **Sigmoid**:$\sigma(x) = \frac{1}{1 + e^{-x}}$
- **ReLU** (Rectified Linear Unit):$\text{ReLU}(x) = \max(0, x)$
- **Tanh**:$\text{tanh}(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}}$
- **Leaky ReLU**:$\text{Leaky ReLU}(x) = \max(0.01x, x)$
### 2.4 优化算法
优化算法用于在训练过程中调整神经网络的参数,以最小化损失函数。常见的优化算法包括:
- **梯度下降法(Gradient Descent)**:根据损失函数的梯度更新参数。
- **批量梯度下降(Batch Gradient Descent)**:使用整个训练集计算梯度。
- **随机梯度下降(Stochastic Gradient Descent, SGD)**:每次使用一个样本计算梯度。
- **小批量梯度下降(Mini-Batch Gradient Descent)**:每次使用一个小批量样本计算梯度。
- **自适应学习率优化算法**:
- **AdaGrad**:根据历史梯度自适应调整每个参数的学习率。
- **RMSprop**:对AdaGrad进行改进,缓解学习率快速衰减的问题。
- **Adam**:结合了AdaGrad和RMSprop的优点,自适应调整学习率,具有较快的收敛速度。
通过以上两个章节的学习,读者可以初步理解深度学习的基础知识,以及人工神经网络的基本原理和训练方法,为后续深入学习更复杂的模型和技术奠定基础。
## 3. Transformer
### 3.1 Transformer简介
Transformer是一种基于自注意力机制的深度学习模型,由Vaswani等人在2017年提出。它克服了RNN在处理长序列时的局限性,具有并行计算的优势,被广泛应用于自然语言处理(NLP)和计算机视觉等领域。
### 3.2 自注意力机制(Self-Attention)
自注意力机制是Transformer的核心,通过计算输入序列中各位置之间的相似度,实现信息的动态加权。
给定输入序列 $X = [x_1, x_2, ..., x_n]$,计算每个位置的Query $Q$、Key $K$ 和 Value $V$:
$$Q = XW_Q$$
$$K = XW_K$$
$$V = XW_V$$
其中, $W_Q, W_K, W_V$ 是学习到的权重矩阵。
注意力权重 $\alpha$ 的计算公式为:
$$\alpha_{ij} = \frac{\exp(e_{ij})}{\sum_{k=1}^n \exp(e_{ik})}$$
$$e_{ij} = \frac{(Q_i K_j^T)}{\sqrt{d_k}}$$
其中, $d_k$ 是Key的维度。
最终的自注意力输出为:
$$Z = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
### 3.3 多头注意力机制(Multi-Head Attention)
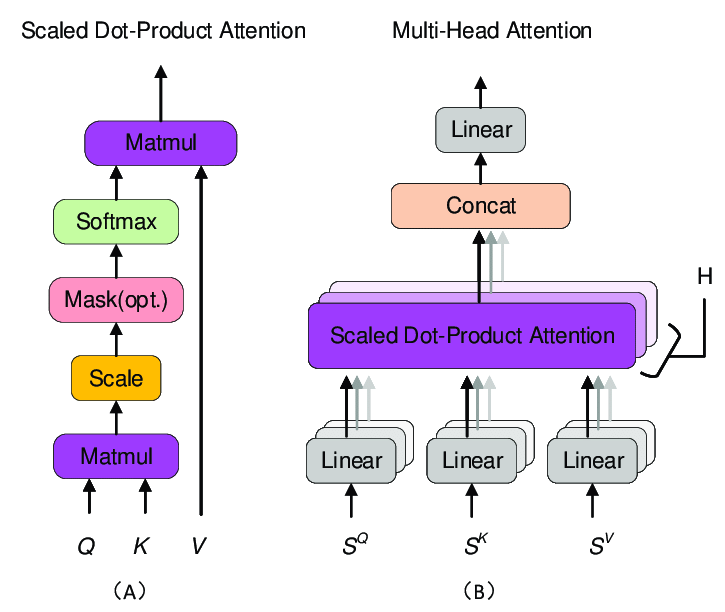
多头注意力机制通过并行计算多个自注意力,将其结果进行拼接,以捕捉不同子空间的信息。
多头注意力机制通过并行计算多个独立的自注意力头,每个头有独立的查询、键和值的权重矩阵:
1. **计算查询、键和值**:
$$
Q_i = XW_{Q_i}, \quad K_i = XW_{K_i}, \quad V_i = XW_{V_i}
$$
其中,$W_{Q_i}, W_{K_i}, W_{V_i} \in \mathbb{R}^{d_{\text{model}} \times d_k}$, $d_k = \frac{d_{\text{model}}}{h}$。
2. **计算缩放点积注意力**:
$$
\text{Attention}(Q_i, K_i, V_i) = \text{softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right)V_i
$$
其中, $Q_i \in \mathbb{R}^{n \times d_k}$, $K_i \in \mathbb{R}^{n \times d_k}$, $V_i \in \mathbb{R}^{n \times d_k}$。
3. **多头拼接**:将所有头的输出拼接起来,并通过一个线性变换:
$$
\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \text{head}_2, \ldots, \text{head}_h)W_O
$$
其中, $\text{head}_i = \text{Attention}(Q_i, K_i, V_i)$,拼接后得到的矩阵维度为 $\mathbb{R}^{n \times d_{\text{model}}}$, $W_O \in \mathbb{R}^{d_{\text{model}} \times d_{\text{model}}}$。
下图展示了多头注意力机制的结构:
### 3.4 位置编码(Positional Encoding)
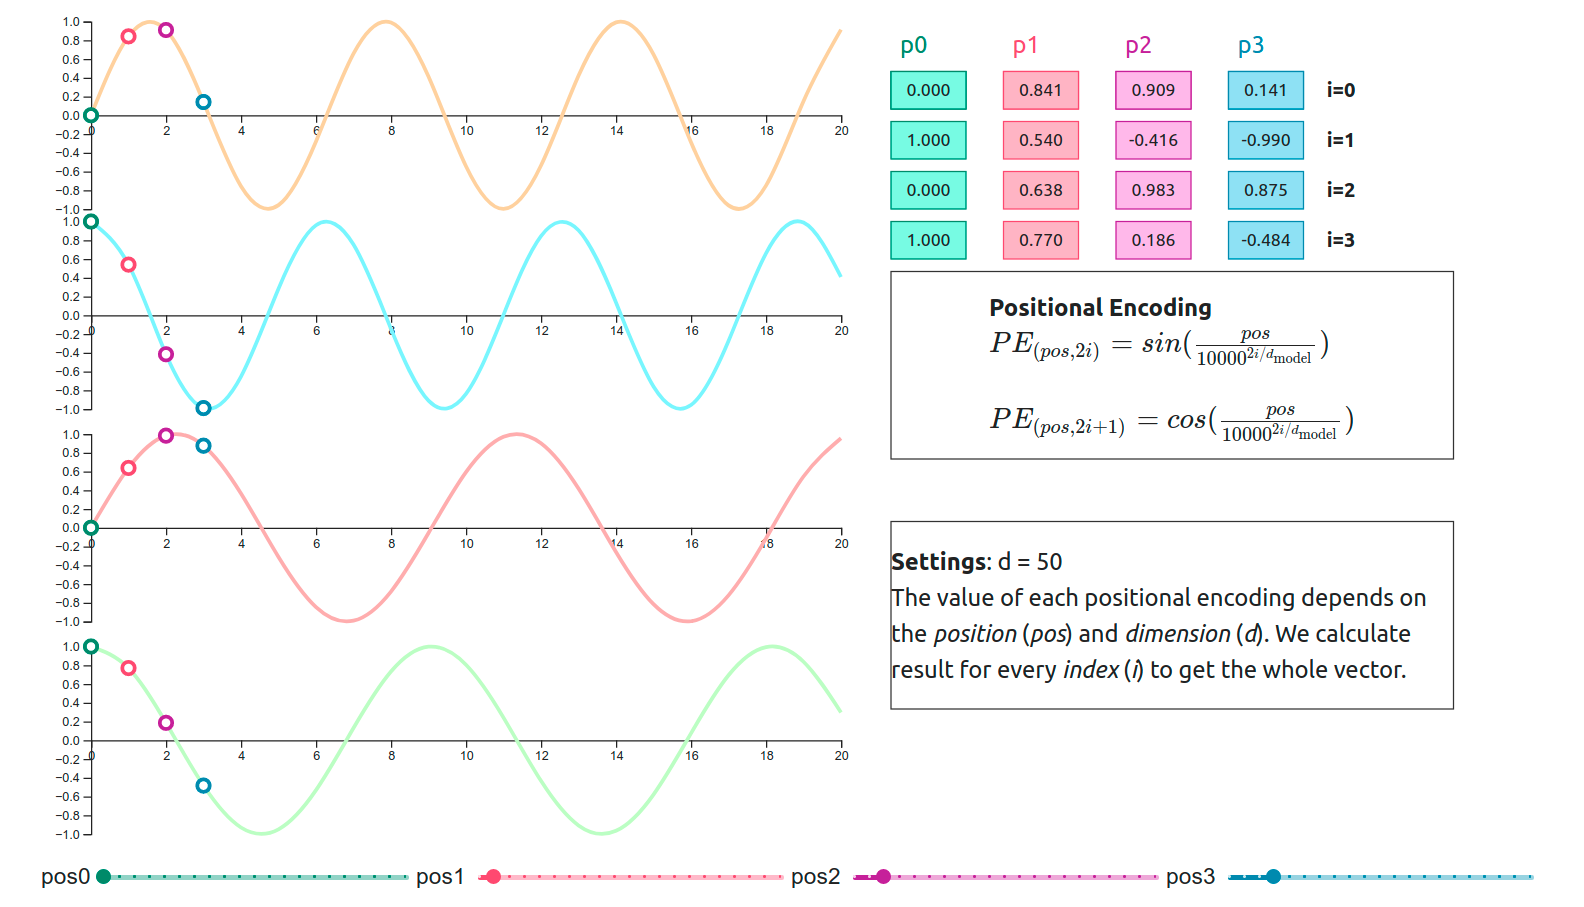
Transformer没有显式的顺序信息,因此需要加入位置编码。位置编码将输入序列的位置信息编码到输入向量中。
位置编码的公式为:
$$\text{PE}_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{model}}}\right)$$
$$\text{PE}_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)$$
其中, $pos$ 是位置, $i$ 是维度索引, $d_{model}$ 是模型的维度。
下图展示了位置编码的示意图:
### 3.5 Transformer的编码器和解码器结构
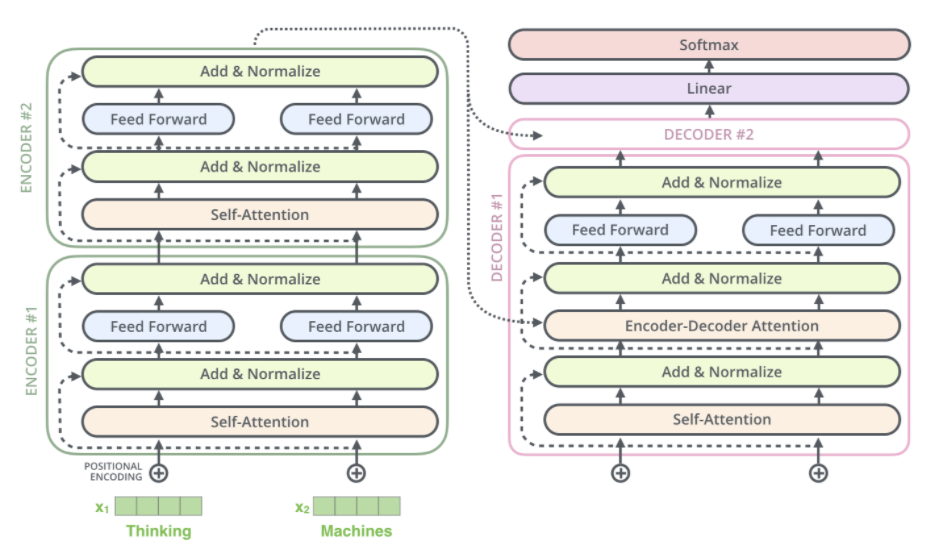
Transformer由编码器和解码器组成,每个编码器和解码器包含多个相同的层。
- **编码器**:每个编码器层包含两个子层:多头自注意力机制和前馈神经网络。每个子层后都使用层归一化(Layer Normalization)和残差连接(Residual Connection)��
编码器层的公式为:
$$\text{Attention Output} = \text{MultiHead}(Q, K, V)$$
$$\text{SubLayer Output}_1 = \text{LayerNorm}(X + \text{Attention Output})$$
$$\text{FFN Output} = \text{FFN}(\text{SubLayer Output}_1)$$
$$\text{SubLayer Output}_2 = \text{LayerNorm}(\text{SubLayer Output}_1 + \text{FFN Output})$$
- **解码器**:每个解码器层包含三个子层:多头自注意力机制、编码器-解码器注意力和前馈神经网络。每个子层后也使用层归一化和残差连接。
解码器层的公式为:
$$\text{Self-Attention Output} = \text{MultiHead}(Q, K, V)$$
$$\text{SubLayer Output}_1 = \text{LayerNorm}(X + \text{Self-Attention Output})$$
$$\text{Enc-Dec Attention Output} = \text{MultiHead}(Q, K, V)$$
$$\text{SubLayer Output}_2 = \text{LayerNorm}(\text{SubLayer Output}_1 + \text{Enc-Dec Attention Output})$$
$$\text{FFN Output} = \text{FFN}(\text{SubLayer Output}_2)$$
$$\text{SubLayer Output}_3 = \text{LayerNorm}(\text{SubLayer Output}_2 + \text{FFN Output})$$
下图展示了Transformer的整体结构:

### 3.6 Transformer的应用
Transformer在多个领域中取得了广泛应用:
- **机器翻译**:Transformer最初被应用于机器翻译任务,如英德翻译。
- **文本生成**:通过训练Transformer模型,可以生成高质量��文本内容,如GPT系列模型。
- **文本分类**:使用Transformer模型提取文本特征,进行分类任务。
- **问答系统**:基于Transformer的BERT模型在问答任务中表现优异。
- **图像处理**:Transformer在图像分类、目标检测等任务中也取得了良好效果。
以上内容详细描述了Transformer的结构和原理,通过公式和图示帮助理解其工作机制。
### 3.7 Tranformer细节答疑
#### Q和K的乘积为什么要缩放 $\frac{1}{\sqrt{d_k}}$ 倍?
在自注意力机制中,查询(Query)和键(Key)的点积决定了注意力权重。如果没有缩放,点积值的方差会随着维度 $d_k$ 增加而增大,这可能导致注意力权重在softmax函数中梯度消失或梯度爆炸。因此,需要进行缩放。
- **方差分析**:假设查询和键的每个分量均值为0,方差为1,那么它们的点积期望值为0,方差为 $d_k$。当 $d_k$ 较大时,点积的值范围较大。
- **缩放目的**:为了避免较大的值导致softmax输出非常小的梯度,需要将点积缩放,使其值范围适中。
具体地,点积公式为:
$$e_{ij} = \frac{Q_i \cdot K_j^T}{\sqrt{d_k}}$$
通过除以 $\sqrt{d_k}$,将点积值缩小,使其方差接近1,从而使softmax函数在计算注意力权重时更稳定。
#### 位置编码中三角函数的分母是怎么来的,有什么��义?为什么底数为10000?为什么指数要乘以2倍再除以 $d_{model}$?
分母 $10000^{2i/d_{model}}$ 的设计是为了生成不同频率的三角函数,这些不同频率使得每个位置在不同维度上有唯一的编码。
1. **指数设计**:指数部分 $\frac{2i}{d_{model}}$ 确保频率从低到高均匀分布, $i$ 是维度索引, $d_{model}$ 是模型的维度。
- 对于较低维度(例如 $i = 0$),频率较高,变化较快。
- 对于较高维度(例如 $i$ 接近 $d_{model}$),频率较低,变化较慢。
2. **底数选择**:10000是一个经验值,大量实验表明它能有效地捕捉序列中的位置关系。
- 如果选择更大或更小的底数,编码的频率范围会变化,可能会影响模型对不同位置的分辨能力。
#### Transformer整体的输入和输出的格式、形状和含义分别是什么?Embedding怎么初始化?有什么含义?
Transformer的输入和输出的格式和形状如下:
- **输入**:
- 格式:词嵌入矩阵 $X$
- 形状:$(n_{batch}, n_{seq}, d_{model})$
- 含义:输入序列的词嵌入表示,其中 $n_{batch}$ 是批量大小,$n_{seq}$ 是序列长度,$d_{model}$ 是词嵌入维度。
- **输出**:
- 格式:输出序列的词嵌入矩阵 $Y$
- 形状:$(n_{batch}, n_{seq}, d_{model})$
- 含义:输出序列的词嵌入表示,其�� $n_{batch}$ 是批量大小,$n_{seq}$ 是序列长度,$d_{model}$ 是词嵌入维度。
**Embedding初始化**:
- Embedding初始化通常采用随机初始化方法,例如均匀分布或正态分布。初始化后,词嵌入矩阵 $E$ 的形状为 $(v_{size}, d_{model})$,其中 $v_{size}$ 是词汇表大小,$d_{model}$ 是词嵌入维度。
- 含义:词嵌入矩阵 $E$ 将每个词映射到一个 $d_{model}$ 维度的向量表示。
#### LayerNorm的具体实现?LayerNorm中的残差链接具体怎么实现?是否要求保证每个FFN、MHA和LayerNorm层的输入输出维度都一致?
**LayerNorm的具体实现**:
Layer Normalization (LayerNorm) 的公式如下:
$$\text{LayerNorm}(x) = \frac{x - \mu}{\sigma + \epsilon} \cdot \gamma + \beta$$
其中, $\mu$ 和 $\sigma$ 分别是输入 $x$ 的均值和标准差, $\gamma$ 和 $\beta$ 是可学习的参数。
**输入输出维度一致性**:
Transformer的各层(MHA、FFN、LayerNorm)的输入输出维度必须一致,均为 $d_{model}$。这保证了残差连接操作能够进行维度相加。
#### 编码器的最终结果是如何输入解码器的?
编码器的最终结果作为解码器的键(Key)和值(Value)输入。在解码器中,多头注意力机制(Multi-Head Attention)利用编码器的输出进行计算:
1. **编码器输出**: $E \in \mathbb{R}^{n_{seq} \times d_{model}}$
2. **解码器的键和值**:编码器输出 $E$ 作为解码器的 Key $K$ 和 Value $V$ 输入。
解码器的注意力计算:
$$\text{Attention}(Q, K, V)$$
其中 $Q$ 是解码器的查询(Query),由解码器输入计算得到,$K$ 和 $V$ 是编码器的输出。
#### 编码器和解码器是如何堆叠多个的?
编码器和解码器均由多个相同的层堆叠而成。
**编码器堆叠**:
多个编码器层堆叠:
$$E^{(l+1)} = \text{EncoderLayer}(E^{(l)})$$
**解码器堆叠**:
多个解码器层堆叠:
$$D^{(l+1)} = \text{DecoderLayer}(D^{(l)}, E)$$
其中 $E$ 是编码器的输出, $D$ 是解码器的输入。
#### 什么是自回归?
自回归(Autoregressive)模型是一种生成模型,它在生成序列的过程中,每一步都利用之前已经生成的词来预测下一个词。这种模型通过学习训练数据中的词序列之间的条件概率来生成新的序列。自回归模型的核心思想是分解联合概率分布为一系列的条件概率,从而逐步生成序列。
**数学表达**:
给定训练文本序列 $X = [x_1, x_2, \ldots, x_n]$,模型的目标是最大化下一个词的条件概率:
$$
P(X) = \prod_{t=1}^{n} P(x_t | x_{<t}; \theta)
$$
**损失函数**:
预训练的损失函数是负对数似然损失(Negative Log-Likelihood Loss):
$$
\mathcal{L}_{\text{LM}} = - \sum_{t=1}^{n} \log P(x_t | x_{<t}; \theta)
$$
#### Transformer在机器翻译任务中,训练和推理具体是怎么执行的?什么是Masked Multi-Head Attention?
##### Transformer推理过程
###### 自回归生成
在Transformer模型中,推理过程通常是自回归的,这意味着每个时间步生成一个词,利用之前已经生成的词作为上下文输入。
1. **自回归生成过程**:
- 初始输入:给定一个初始文本序列(例如,[CLS],或一段文本的开头)。
- 编码:每个时间步编码器的输入不变,因此只需在初始输入后编码一次,得到上下文表示。
- 逐步生成:解码器在每个时间步生成一个新的词,并将这个词添加到输入序列中,作为下一个时间步的输入。
- 重复这一过程,直到生成完成所需的序列长度。
2. **计算量**:
- 对于生成长度为 \( T \) 的序列,模型需要运行 \( T \) 次,每次使用之前的所有词作为输入。
- 这意味着生成每个词都需要前向传播一次整个Transformer网络,导致推理时间随序列长度线性增加。
##### Transformer训练过程
###### 自回归训练
与推理过程相同,每个时间步编码器的输入不变,依然是原始输入,解码器的输入是之前生成的内容和编码器的上下文表示,然后学习下一个词的预测结果。
###### 非自回归训练
与推理过程不同,Transformer模型在训练时通常使用非自回归的方式进行,以并行处理整个序列,提高训练效率。
1. **全序列输入**:
- 在训练时,整个输入序列(包含目标序列的词)同时输入到模型中。
- 通过并行计算,自注意力机制可以同时处理序列中的所有位置。
2. **Masked Multi-Head Attention的作用**:
- 在训练过程中,解码器使用 **Masked Multi-Head Attention** 来确保模型在每个时间步只能看到之前的位置。
- 遮掩机制屏蔽了当前时间步之后的词,从而避免模型看到未来的信息。
**具体训练步骤:**
1. **输入和目标序列**:
- 输入序列 \( X = [x_1, x_2, \ldots, x_n] \) 和目标序列 \( Y = [y_1, y_2, \ldots, y_m] \)。
- 对于机器翻译任务,输入序列是源语言句子,目标序列是目标语言句子。
2. **编码器**:
- 编码器接收输入序列 \( X \),通过一系列编码器层,生成上下文表示 \( H = [h_1, h_2, \ldots, h_n] \)。
3. **解码器**:
- 解码器接收目标序列 \( Y \) 和编码器的上下文表示 \( H \)。
- 解码器的每一层使用 **Masked Multi-Head Attention** 机制,只允许每个时间步看到之前的词。
- 通过解码器层的计算,生成目标序列的预测值。
4. **��失函数**:
- 使用交叉熵损失函数,计算模型预测值和真实目标序列之间的误差:
\[
\mathcal{L} = - \sum_{t=1}^{m} \log P(y_t | y_{<t}, X; \theta)
\]
5. **并行计算**:
- 由于使用了全序列输入和 **Masked Multi-Head Attention**,整个序列的每个位置可以并行计算,极大地提高了训练效率。
### 3.8 T5简介
T5(Transfer Text-to-Text Transformer)是一种预训练语言模型,旨在通过将所有自然语言处理(NLP)任务统一为文本到文本格式,来解决各种NLP问题。
T5和Transformer模型在**模型结构、目标任务以及训练策略**详细对比:
1. **模型结构**
- T5采用了Transformer的encoder-decoder结构,但是移除 Layer Norm bias并将 layer normalization 放在残差路径外面
- 与之前的Transformer模型的绝对位置编码不同,T5使用简化的相对位置编码,每个位置对应一个数值而不是向量,共32种;且位置编码不是直接加在Embedding上,这使得模型能够更敏感地捕捉单词间的位置关系。
2. **目标任务和训练策略**
- T5将所有NLP任务统一为文本到文本格式,即输入和输出都是文本。例如,在翻译任务中,输入是“translate English to German: That is good”,输出则是德语翻译“Das ist gut”。
- 所有的任务都变成 “text -to - text” 形式的任务。所以可以统一使用标准的最大似然目标函数来训练(teacher forcing自回归, cross-entropy loss ),优化器AdaFactor。
## 4. BERT/RoBERTa
### 4.1 BERT架构细节与Transformer对比
BERT(Bidirectional Encoder Representations from Transformers)基于Transformer编码器。与原始Transformer相比,BERT专注于利用上下文信息对每个词进行编码,而Transformer更常用于序列到序列的生成式任务(如机器翻译)。
**BERT的架构**:
1. **输入嵌入**:
- **词嵌入(Token Embeddings)**:每个token一个固定维度的向量。
- **位置嵌入(Position Embeddings)**:与transformer一致的位置编码(非可学习参数),以描述序列中每个词的位置信息。
- **分段嵌入(Segment Embeddings)**:区分句子A和句子B的标记,句子之间。
输入序列 $X$ 的嵌入表示为:
$$E = E_t + E_p + E_s$$
[CLS]和[SEP]都有专用的词嵌入;[CLS]的分段嵌入是句子A的分段嵌入,[SEP]则取决于其属于哪句话的结尾。
2. **编码器层**:BERT由多层堆叠的Transformer编码器组成,每层包括多头自注意力机制(Multi-Head Self-Attention)和前馈神经网络(Feed-Forward Network)。
3. **输出表示**:编码器输出每个位置的上下文表示,特别是 [CLS] 标记对应的位置,常用于分类任务的最终表示。
### 4.2 BERT的预训练
BERT的预训练包括两个任务:Masked Language Model (MLM) 和 Next Sentence Prediction (NSP)。
#### 4.2.1 Masked Language Model (MLM)
MLM任务中,输入序列中的一些词被随机掩码,模型需要预测这些掩码位置的原始词。
- **掩码过程**:对于输入序列 $X = [x_1, x_2, \ldots, x_n]$,随机选择一些位置 $M \subseteq \{1, 2, \ldots, n\}$ 进行掩码,形成序列 $\tilde{X}$。
- 掩码策略:80%的概率替换为 [MASK] 标记,10%的概率保持不变,10%的概率替换为随机词。
- **损失函数**:使用交叉熵损失函数衡量模型预测的准确性。
$$\mathcal{L}_{MLM} = - \sum_{i \in M} \log P(x_i | \tilde{X})$$
#### 4.2.2 Next Sentence Prediction (NSP)
NSP任务中,模型需要判断句子对中的第二个句子是否是第一个句子的下一句。
- **输入格式**:将句子对 $(A, B)$ 拼接成一个序列,用特殊标记 [SEP] 分隔句子,并在序列开头添加标记 [CLS]。
$$X = [\text{[CLS]}, A, \text{[SEP]}, B, \text{[SEP]}]$$
- **损失函数**:使用交叉熵损失函数衡量模型预测的准确性。
$$\mathcal{L}_{NSP} = - y \log \hat{y} - (1 - y) \log (1 - \hat{y})$$
其中,$y$ 为标签(1 表示句子 $B$ 是句子 $A$ 的下一句,0 表示否),模型预测的概率为 $\hat{y}$。
### 4.3 RoBERTa与BERT的差异
RoBERTa(Robustly optimized BERT approach)是对BERT进行改进的模型,主要区别在于预训练的策略和超参数的调整。
1. **更大的训练数据集**:RoBERTa使用了更大的训练数据集,比BERT的原始数据集大了十倍以上。
2. **去除NSP任务**:RoBERTa仅使用MLM任务进行预训练,去除了NSP任务。
3. **动态掩码**:RoBERTa在每次训练迭代时动态生成掩码,而BERT在预处理时就固定了掩码。
4. **更长的训练时间和更大的批量大小**:RoBERTa增加了训练的迭代次数和批量大小,从而提高模型的性能。
### 4.4 BERT/RoBERTa在下游任务中的微调与应用
#### 4.4.1 分类任务
在文本分类任务中,BERT模型的应用主要集中在利用 [CLS] 标记的隐藏状态进行分类。具体步骤如下:
1. **输入序列**:将输入文本序列通过BERT进行编码,得到每个词的隐藏状态表示。
$$H = [h_{\text{[CLS]}}, h_1, h_2, \ldots, h_n]$$
其中,$h_{\text{[CLS]}}$ 是 [CLS] 标记对应的隐藏状态,代表整个序列的全局信息。
2. **分类层**:将 [CLS] 标记对应的隐藏状态 $h_{\text{[CLS]}}$ 输入到一个全连接层,然后通过softmax函数输出类别概率。
$$\hat{y} = \text{softmax}(W h_{\text{[CLS]}} + b)$$
其中,$W$ 和 $b$ 是可训练的参数。
3. **损失函数**:使用交叉熵损失函数进行优化。
$$\mathcal{L}_{\text{classification}} = - \sum_{i} y_i \log \hat{y}_i$$
其中,$y_i$ 是真实类别标签,$\hat{y}_i$ 是模型预测的类别概率。
#### 4.4.2 BIO标注
在命名实体识别(NER)任务中,通常采用BIO标注方法(Begin, Inside, Outside),即每个词被标记为实体的开头(B),实体内部(I),或非实体(O)。具体步骤如下:
1. **输入序列**:将输入文本序列通过BERT进行编码,得到每个词的隐藏状态表示。
$$H = [h_{\text{[CLS]}}, h_1, h_2, \ldots, h_n]$$
2. **标注层**:对每个词的隐藏状态 $h_t$ 输入到一个全连接层,然后通过softmax函数输出标注类别概率。
$$\hat{y}_t = \text{softmax}(W h_t + b)$$
其中,$W$ 和 $b$ 是可训练的参数。
3. **损失函数**:使用交叉熵损失函数进行优化。
$$\mathcal{L}_{\text{NER}} = - \sum_{t} y_t \log \hat{y}_t$$
其中,$y_t$ 是真实的BIO标注,$\hat{y}_t$ 是模型预测的标注概率。
### 4.5 BERT细节答疑
#### 为什么说编码器是双向的,解码器是单向的?基于文本分类任务,从输入、训练过程和损失等角度讨论。
**双向编码器与单向解码器的区别**:
1. **双向编码器**:在BERT模型中,编码器是双向的,这意味着在计算每个位置的隐藏状态时,模型同时考虑了该位置之前和之后的所有词。
- **输入**:对于输入序列 $X = [x_1, x_2, \ldots, x_n]$,编码器接收整个序列并处理。
- **训练过程**:编码器中的自注意力机制能够关注序列中的任意位置,因此能够同时利用左侧和右侧的上下文信息。
- **损失函数**:在预训练阶段,BERT通过MLM和NSP任务进行训练,这两个任务都依赖于双向信息的捕捉。具体的损失函数如交叉熵损失用于衡量模型预测的准确性。
公式如下:
$$\mathcal{L}_{MLM} = - \sum_{i \in M} \log P(x_i | \tilde{X})$$
$$\mathcal{L}_{NSP} = - y \log \hat{y} - (1 - y) \log (1 - \hat{y})$$
总损失函数:
$$\mathcal{L}_{BERT} = \mathcal{L}_{MLM} + \mathcal{L}_{NSP}$$
2. **单向解码器**:在标准Transformer中,解码器是单向的,这意味着在生成每个位置的隐藏状态时,只考虑该位置之前的词。解码器常用于生成任务,如机器翻译。
- **输入**:对于序列生成任务,如机器翻译,解码器输入是部分生成的序列。
- **训练过程**:解码器的自注意力机制只关注当前位置及其之前的词,不关注后面的词。
- **损失函数**:通常使用交叉熵损失来计算生成序列和目标序列之间的差异。
公式如下:
$$\mathcal{L}_{\text{translation}} = - \sum_{t} \log P(y_t | y_{<t}, X)$$
其中, $y_t$ 是目标序列在时间步 $t$ 的词。
## 5. GPT (Generative Pre-trained Transformer)
### 5.1 GPT简介
GPT(Generative Pre-trained Transformer)是由OpenAI提出的一种生成式预训练模型,基于Transformer架构。其主要特点是通过大规模的文本数据进行预训练,使得模型在处理各种自然语言生成任务时表现出色。
### 5.2 GPT的架构与BERT的区别
1. **方向性**:
- **BERT**:使用双向Transformer编码器,同时利用上下文信息进行预测。
- **GPT**:使用单向Transformer解码器,自回归地生成文本,只利用前向信息。
2. **输入处理**:
- **BERT**:输入序列中的一些词被随机掩码,模型需要预测这些掩码位置的词。
- **GPT**:输入序列不进行掩码,模型在每个时间步预测下一个词。
3. **训练目标**:
- **BERT**:通过MLM(Masked Language Model)和NSP(Next Sentence Prediction)任务进行预训练。
- **GPT**:通过语言模型任务进行预训练,最大化下一个词的概率。
### 5.3 GPT的训练过程
GPT的训练过程可以分为预训练和微调两个阶段。
1. **预训练**:
预训练阶段的目标是通过大规模的未标注文本数据来学习通用的语言表示。预训练使用自回归语言模型(Autoregressive Language Model)的方式进行。
2. **微调**:
微调阶段是在特定的下游任务数据集上进行训练。预训练好的模型通过在下游任务数据集上继续训练,适应特定任务的需求。
### 5.4 混合专家MoE
### 5.4 混合专家(MoE)
混合专家(Mixture of Experts,MoE)是一种深度学习技术,通过引入多个子模型(专家),每个子模型专门处理特定的输入子集,从而提高模型的效率和性能。
1. **多专家模型**:MoE模型由多个独立的子模型(称为专家)组成,每个专家负责处理不同的输入特征或任务。
2. **稀疏激活**:在MoE架构中,并不是所有的专家在每次输入时都被激活。使用门控网络根据输入特征计算每个专家的权重,并选择权重最高的几个专家进行计算。这种稀疏激活方式提高了计算效率,减少了资源消耗。
#### 数学表达
1. **专家的输出**:
给定输入 $x$,每个专家 $E_i$ 生成一个输出 $y_i = E_i(x)$。
2. **门控网络**:
门控网络 $G$ 根据输入 $x$ 生成每个专家的权重 $g_i$:
$$
g = G(x), \quad g_i \in [0, 1], \quad \sum_{i=1}^k g_i = 1
$$
其中,$k$ 是专家的数量。
3. **稀疏激活**:
门控网络根据权重选择前 $k$ 个专家进行激活,并将其输出加权求和得到最终输出 $y$:
$$
y = \sum_{i \in \text{TopK}(g)} g_i E_i(x)
$$
其中,$\text{TopK}(g)$ 表示选择权重最高的 $k$ 个专家。
#### 实例:GPT-4中的MoE
在GPT-4中,混合专家架构被用来提高生成模型的效率和性能。具体而言,GPT-4使用了8个各自包含2200亿参数的小模型,而不是一个单一的大模型。这种设计允许每个输入示例根据需要动态地选择和激活不同的专家,从而实现稀疏激活。这种架构显著提高了模型的参数规模和处理能力,同时保持了较低的计算成本。
![]()