# ViT、CLIP、BLIP
## ViT
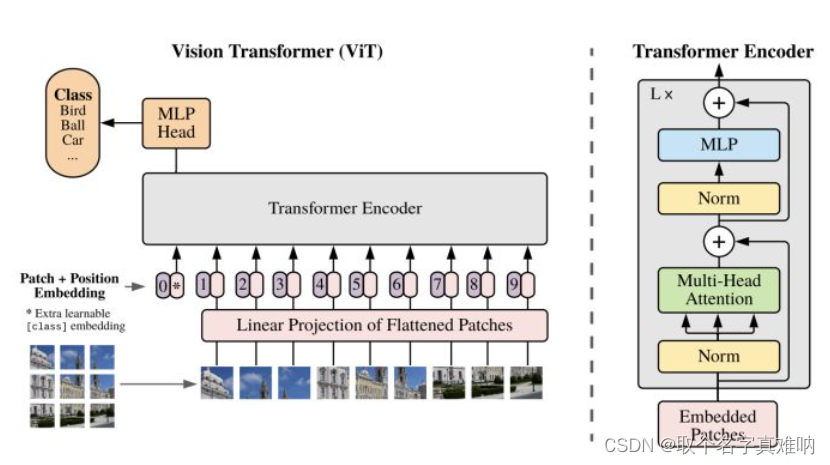
将图像切割成小块(Patches),然后拍扁(Flatten),经过线性投影后作为token输入到Transformer中。仅使用了Encoder部分。
## CLIP
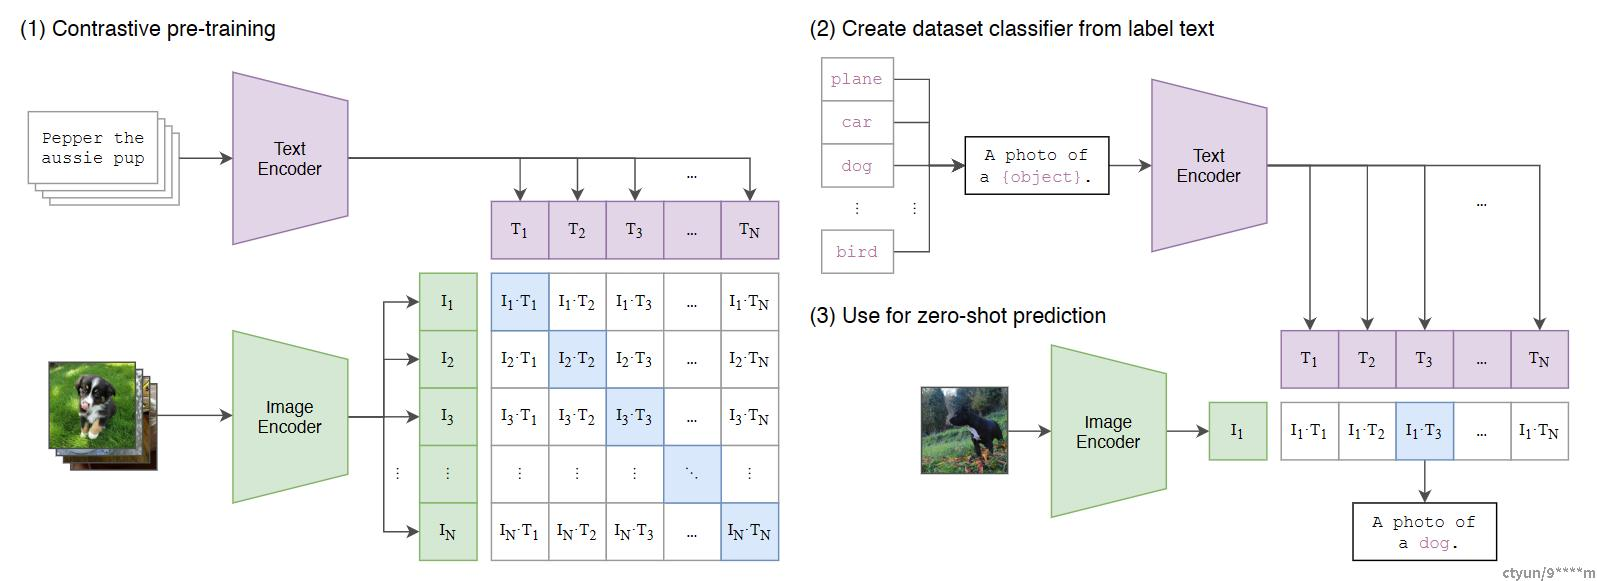
CLIP的核心思想是用图像和文本之间的语义相似性来训练一个视觉-语言模型。具体来说,CLIP使用了一个双塔结构的神经网络,其中一塔是一个图像编码器,另一塔是一个文本编码器。图像编码器负责将图像转换为一个向量表示,文本编码器负责将文本转换为一个向量表示。然后,CLIP使用了一个对比损失函数,来优化这两个向量之间的内积。也就是说,CLIP希望图像和文本之间的内积越大,表示它们越相似;反之,图像和文本之间的内积越小,表示它们越不相似。
### CLIP的应用场景
能够将图像和文本编码到同一个高维空间中,使得两者之间的相似度可以通过它们在这个空间中的距离来衡量。以下是一些关于CLIP模型的例子:
- Zero-Shot Image Classification(零样本图像分类)
- Text-to-Image Retrieval(文本到图像检索)
- Image-to-Text Retrieval(图像到文本检索)
- Visual Question Answering(视觉问题回答)
- Image Captioning(图像描述生成):
- 虽然CLIP本身不直接生成图像描述,但它可以与文本生成模型(如GPT-3)结合使用。首先,CLIP模型将图像编码为向量,然后将该向量作为文本生成模型的输入,以生成描述性文本。
- BLIP在图像描述生成任务中更优
- Multi-Modal Search(多模态搜索)
## BLIP
BLIP比较复杂,可以参考<https://blog.csdn.net/m0_51976564/article/details/134356373>。总体上是一个**扩展了编码器-解码器结构的,利用Bootstrapping方法进行去噪的**视觉语言预训练 (Vision-Language Pre-training, VLP)
### MED 架构
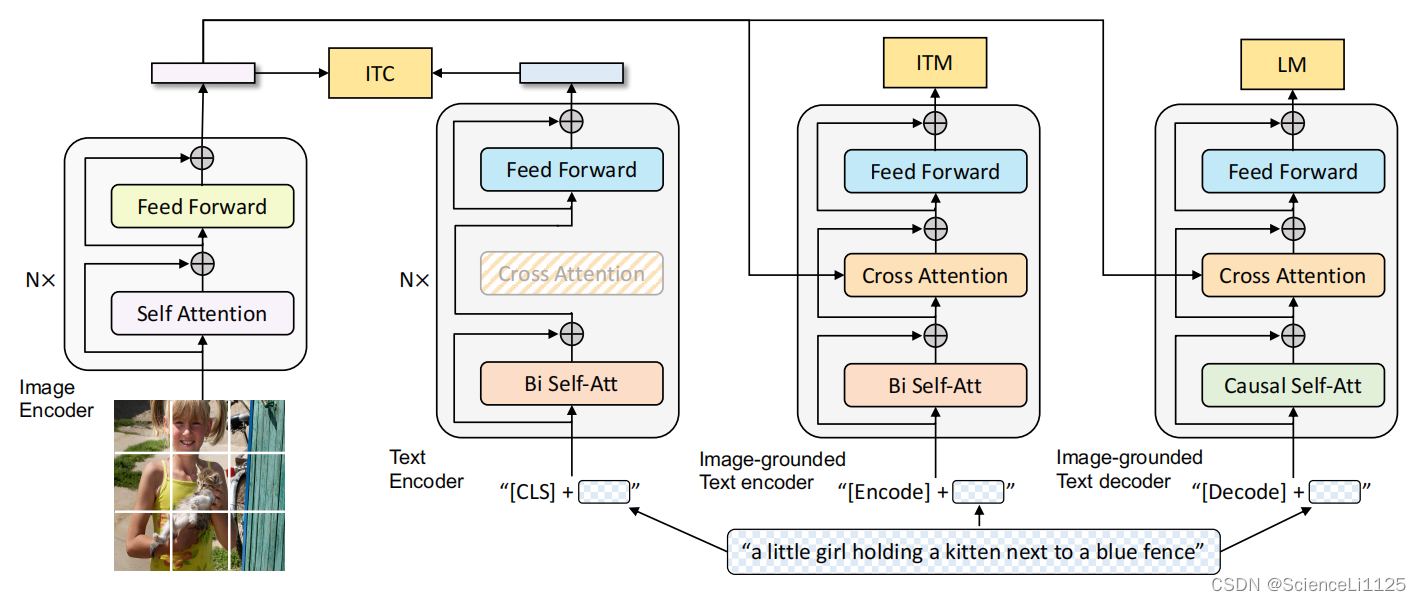
BLIP 采用了基于 编码器 - 解码器的多模态混合结构 (Multimodal mixture of Encoder-Decoder, MED),包括两个单模态编码器、一个以图像为基础的文本编码器和一个以图像为基础的文本解码器:
- 单模态编码器 lmage Encoder:基于 transformer 的 ViT 的架构,将输入图像分割为多个的 patch 并将它们编码为一系列 Image Embedding,并使用 [CLS] token 来表示全局的图像特征。lmage Encoder 用来提取图像特征做对比学习,相当于 CLIP 中的 Image Encoder;
- 单模态编码器 Text Encoder:基于 BERT 的架构,将 [CLS] token 加到输入文本的开头以总结句子。Text Encoder 用来提取文本特征做对比学习,相当于 CLIP 中的 Text Encoder��
- 以图像为基础的编码器 Image-grounded text encoder:在 Text Encoder 的 self-attention 层和前馈网络之间添加一个 交叉注意 (cross-attention, CA) 层用来注入视觉信息,还将 [Encode] token 加到输入文本的开头以标识特定任务。Image-grounded text encoder 用来提取文本特征并将其和图像特征对齐,相当于 CLIP 中更精细化的 Text - Image 对齐;
- 以图像为基础的解码器 Image-grounded text decoder:将 Image-grounded text encoder 的 self-attention 层换成 causal self-attention 层,还将 [Decode] token 和 [EOS] token 加到输入文本的开头和结尾以标识序列的开始和结束。Image-grounded text decoder 用来生成符合图像和文本特征的文本描述,这是 CLIP 中所没有的;
> 注意,Image-grounded text decoder 生成的文本描述不同于输入的图像 - 文本对中的文本,图像 - 文本对中的文本是互联网上找到的图片的上下文,拥有大量的噪音;而 Image-grounded text decoder 生成的文本描述是针对图像特征和文本特征的特定描述,更加精炼。这里其实就已经是 Captioner 的雏形了,下文的 Captioner 也是基于训练完成的 Image-grounded text decoder 再进行的优化和微调。
### 预训练方法
如上图所示,预训练 MED 过程中联合优化了 3 个目标,包括 2 个理解任务的目标函数和 1 个生成任务的目标函数:
- 图文对比损失 (Image-Text Contrastive Loss, ITC):ITC 用于训练 lmage Encoder 和 Text Encoder,通过对比学习对齐图像和文本的特征空间。具体方法是最大化正样本图像 - 文本对的相似度且最小化负样本图像 - 文本对的相似度,从映射的角度讲就是将语义相关的图像 - 文本对映射到空间中的相邻点且语义不相关的图像 - 文本对映射到不相邻的点。这里还使用了 ALBEF 中的动量编码器,目的是产生一些伪标签以辅助模型的训练;
- 图文匹配损失 (Image-Text Matching Loss, ITM):ITM 用于训练 Image-grounded text encoder,通过学习图像 - 文本对的联合表征实现视觉和语言之间的细粒度对齐。具体方法是通过一个二分类任务,预测图像文本对是正样本还是负样本。这里还使用了 ALBEF 中的 hard negative mining 技术以更好地捕捉负样本信息;
> ITM 与 ITC 并不一样,ITC 虽然也对齐了图像和文本的特征空间,但并没有显式地区分正负样本,主要是用于评价图像和文本的匹配情况,给出任意输入图像 - 文本对的相似度。而 ITM 则是通过计算样本的损失达到区分正负样本的目的,激励正样本的图像和文本使其更加匹配。
- 语言建模损失 (Language Modeling Loss, LM):LM 用于训练 Image-grounded text decoder,实现生成图像的文本描述任务。具体方法是通过优化交叉熵损失函数,训练模型以自回归的方式最大化文本的概率。这里还使用了 0.1 的标签平滑计算损失;
**ITC损失两端的向量,实际上充当了和CLIP对比学习到的向量类似的作用**,因此也可以看作是在图文之间进行了对齐。
### CapFilt 机制
COCO 数据集的高质量人工注释图像 - 文本对数量有限,因此 CLIP、BLIP 等 VLP 都是从网络中收集数据作为训练集。但这些网络图像 - 文本对的文本来自图像上下文,难以精准地描述图像内容,存在大量噪声。
于是,文中提出了字幕和过滤 (Captioning and Filtering, CapFilt) 机制:
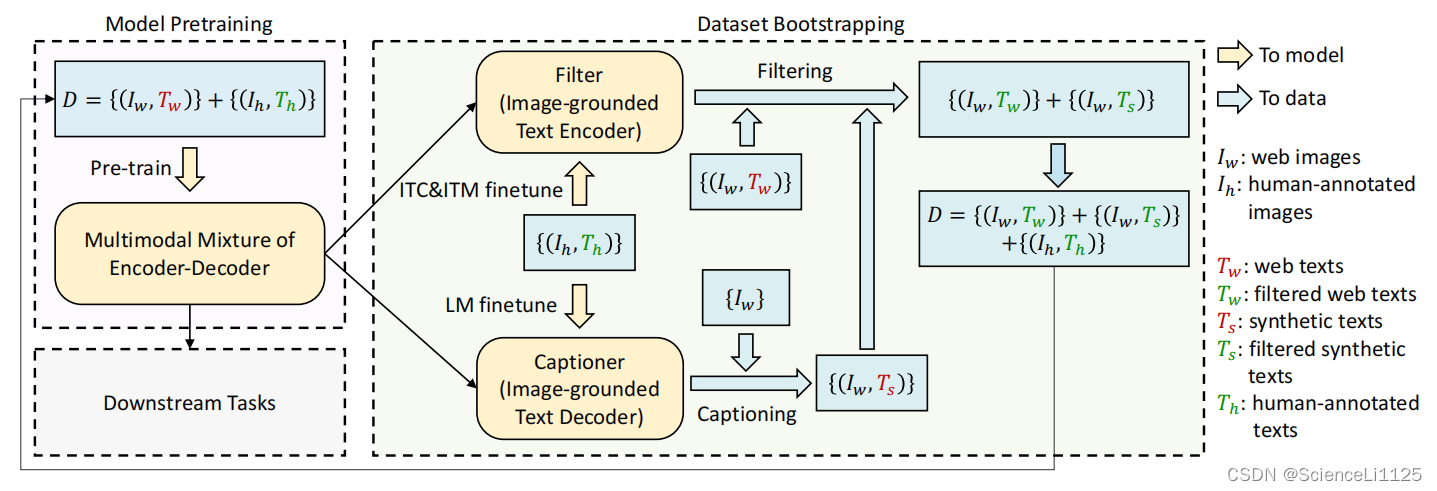
上图给出了 CapFilt 的图示,包含字幕器和过滤器两个模块:
- 字幕器 Captioner:一个视觉文本解码器,基于Image-grounded text decoder,用于生成给定图像的字幕,使用 LM 损失函数在 COCO 数据集上进行微调。给定网络图片,Captioner 生成字幕
- 过滤器 Filter:一个视觉文本编码器,基于 Image-grounded text encoder,用于去除文本噪声,使用 ITC 和 ITM 损失函数在 COCO 数据集上进行微调。Filter 通过比对文本和图像的匹配情况,删除原始 Web 文本和合成文本中的噪声。
Captioner 和 Filter 都是在预训练完成后的 MED 模型上初始化的,并各自在人工注释的图像 - 文本对数据集 COCO 上进行 微调 (finetune)。最后,将过滤后的图像 - 文本对与人工注释对相结合,形成一个新的数据集(这也是 Bootstrapping 的由来),最后再用它来训练一遍模型。
介绍到这里可以大致捋一下 BLIP 的训练思路:先使用含有噪声的网络数据训练一遍 BLIP,再在 COCO 数据集上进行微调以训练 Captioner 和 Filter,然后使用 Filter 从原始网络文本和合成文本中删除嘈杂的字幕,得到干净的数据。最后再使用干净的数据训练一遍得到高性能的 BLIP。
![]()