# 矩阵分解(Matrix Factorization)又名矩阵补充、隐语义模型
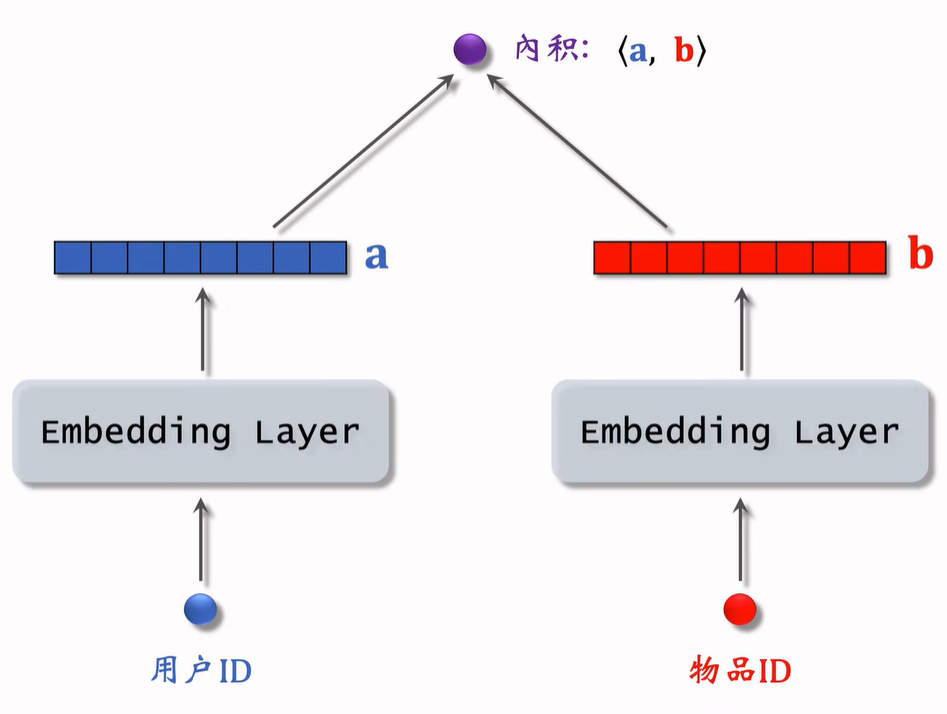
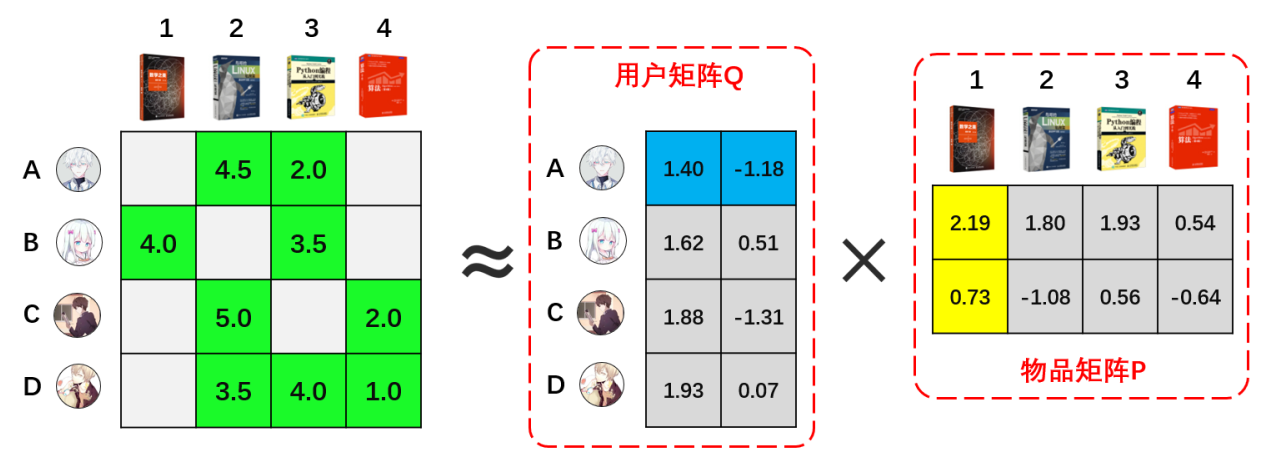
思路是把用户ID $u$ 和物品ID $i$ 分别嵌入到两个同维向量空间中,利用已知的一部分用户物品交互数据和对应的交互分数 $Score(u,i)$,使用最优化方法优化以下函数:
$$
Loss=\sum_{<u,i> \in 用户物��交互} (Score(u, i) - Emb_u \cdot Emb_i)^2
$$
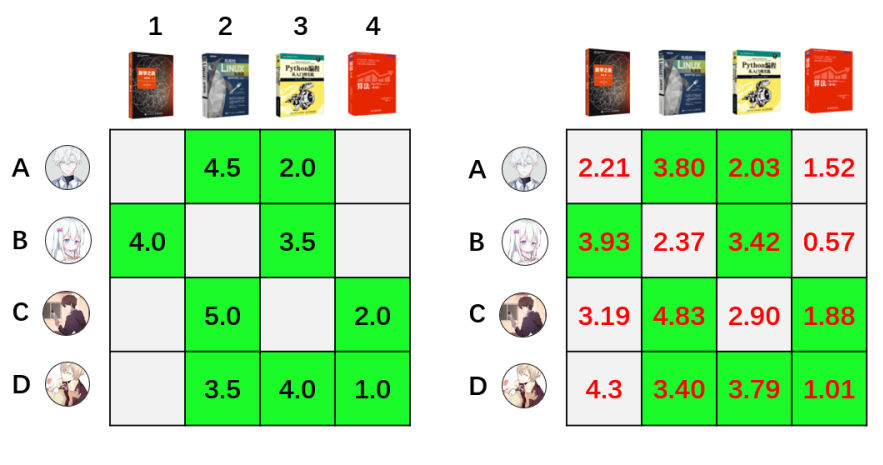
最终的泛化能力由如下公式表示:
$$
\hat{Score(u,i)}=Emb_u \cdot Emb_i
$$
整个流程如下面几张图所示:
> 小贴士:矩阵分解也是一种协同过滤,是“基于模型的协同过滤”
![]()