# 机器学习初步认识
## 机器学习的分类
- 数理学派
- 符号主义
- 贝叶斯
- 联结主义
- 仿生学派
- 进化主义
- 行为类推主义
## 机器学习的发展过程
- 以前的发展过程省略
- 蚁群算法、遗传算法、决策树
- 支持向量机、随机森林
- 神经网络、深度学习
## 机器学习的过程
需求-模型-预处理/执行/调优-评估-部署
(类比软件开发:需求-模型-实现-测试-部署)
## 机器学习算法的分类
### 有监督(Supervised):人工标识数据
- 回归分析(Regression)
- 决策树(Decision Trees)
- 随机森林(Random Forests)
### 无监督(Unsupervised)
- 聚类(Clustering)
- 关联分析(Association Analysis):啤酒换尿布
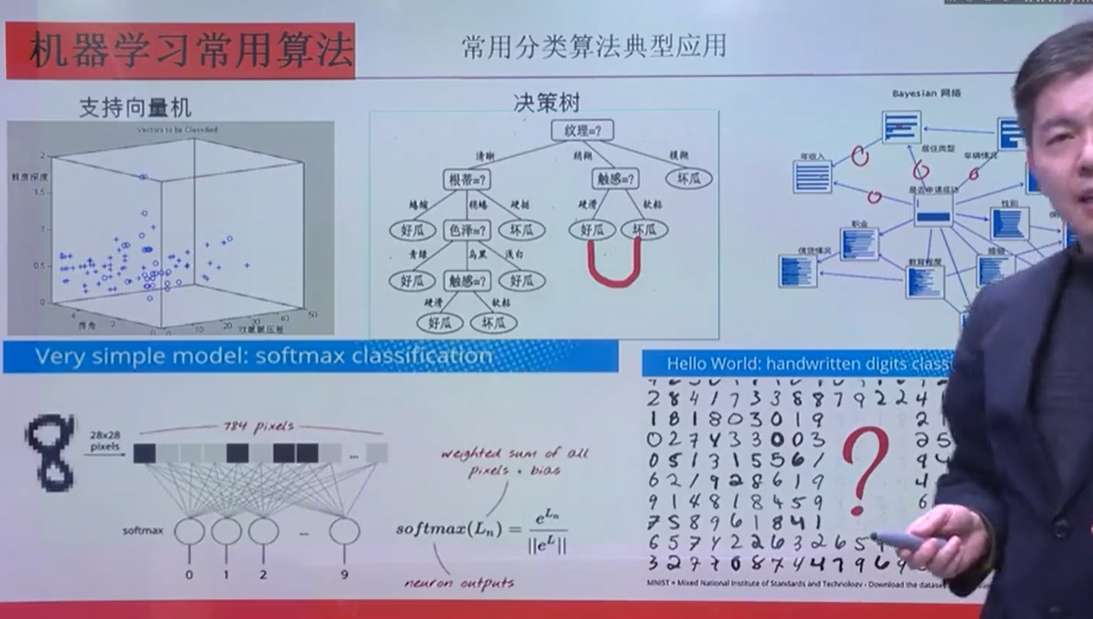
### 分类算法(有监督)
目的:把给定的单个样本预测为某一种类事物
- 训练集-分类算法-分类模型
- 测试集-分类模型-分类结果
- 支持向量机(SVM):低维投影到高维,变得可分
- 决策树:特征在树上路径上形成组合
- 贝叶斯网络:基于概率的推理
- 神经网络:可解释性低
### 聚类算法(无监督)
目的:把给定的样本集分成不同的簇(聚类)
- K-均值(K-means):簇间距离大,簇内距离小
- 基于层次的算法
- 基于密度的算法
- 基于约束的算法
- 神经网络
### 回归分析(有监督)
目的:将离散的样本点拟合为一个函数
### 关联分析(无监督)
目的:建立样本集内看似无关但常常同时发生的某些事间的联系
常见应用:购物车分析,是推荐算法的一种;可以洞察各种套路
关联不一定是因果,可能都是果,也可能因果相反
### 推荐(数据挖掘)
目的:推荐
- 协同过滤
### 社会网络分析-文本分析(数据挖掘)
目的:微博用户情感分析、交通事故分析
### 神经网络
### 深度学习
- 逐层训练的神经网络
## 数据质量问题与预处理
- 数据质量:完备、真实、一致、可靠
- 预处理:占用整个机器学习60%的工作量
- 数据质量常见问题:
- 数据量过少:欠拟合、假规律,数据量应为自变量数量10~20倍
- 数据量过多(重复):数据抽样
- 维度过多
- 数据不完整:抽样时应该多次抽样
- 数据不可靠:异常数据,聚类方法去噪
- 数据不一致
- 欠拟合:underfit
- 过拟合:overfit
![]()