# 语法分析-自顶向下
对给定的某编程语言的目标语句,由一个已知的文法G,从初始符号S开始不断对目标语句从左至右进行推导,最终将目标语句恰好匹配为一个符合文法规则的句子,则完成一次成功的自顶向下语法分析,若不能匹配,则视为出现语法错误。过程中可能因为产生式的多选性而产生回溯。
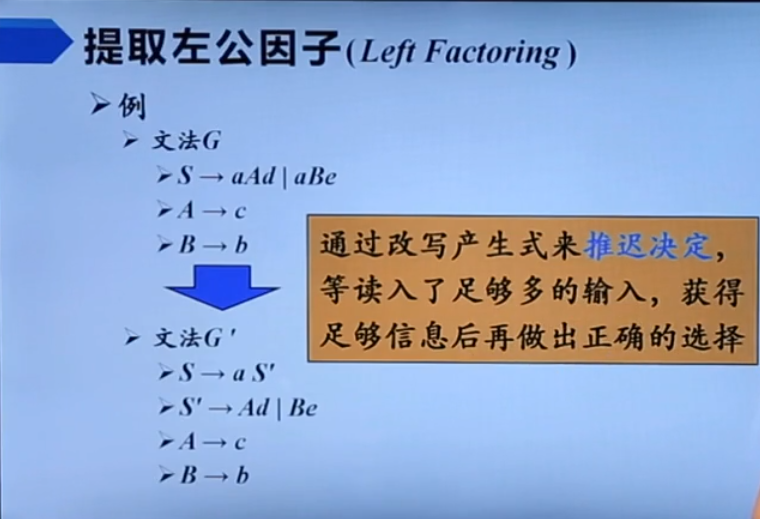
## 提取左前缀
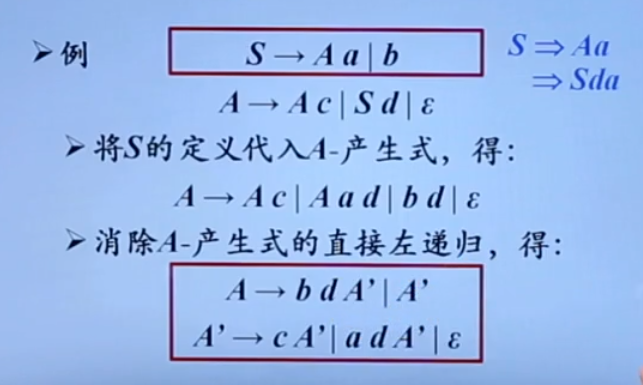
## 消除左递归
- 对直接左递归:枚举原产生式的候选前缀(非左递归的分支,如bd|ε)成为原产生式的右部,每个枚举另外跟随一个
- 新定义的非终结符(如bdA'|A'),其循环生成原产生式的候选后缀(如cA'|adA'|ε)
- 对间接左递归:带入相关子产生式,然后消除子产生式的左递归(如将S→Aa|b带入Sd产生Aad|bd)
## 非终结符的后继终结符集 FOLLOW(X)
即X后可以直接跟什么终结符(或ε)
- 若初始符号S可直接或间接推出以X结尾的串,则`$`$\in$FOLLOW(X)
- 对所有包含X但不以X结尾的产生式中X后续的整个符号串$\beta$,有(FIRST($\beta$) - {ε})$\subset$FOLLOW(X)
- 对所有直接以X结尾的产生式的左部A,有FOLLOW(A)$\subset$FOLLOW(X)。
- 对所有可能以X结尾的产生式(X之后可能全部推出ε)的左部A,有FOLLOW(A)$\subset$FOLLOW(X)。
- 对所有必然以X结尾的产生式(无法直接或间接推出不以X结尾的串)的左部A,有FOLLOW(A)=FOLLOW(X)。
在实际按照产生式的顺序依次进行推导的过程中,推导过程可能执行多次无放回的重复(因为规则中有环路)。
## 文法符号串的首终结符集 FIRST(X)
即该文法符号串(可以有终结符和非终结符)可推出的首个终结符的集合。
- 对X是单个文法符号的情况:
- 若X是终结符,则FIRST(X)={X}
- 若X是非终结符且有$X\rightarrow Y_1\cdots Y_n$,则第一个包含终结符的FIRST($Y_i$) $\subset$ FIRST(X),$i=1,\cdots,n$
- 在无满足条件的FIRST($Y_i$)时,有ε$\in$FIRST($X$)
- 若X是非终结符且有X→ε,则ε$\in$FIRST($A_i$)
- 对X是文法符号串的情况,构造$X'\rightarrow X$,有FIRST($X'$)=FIRST($X$)
## 产生式的可选集 SELECT(X→α)
即可用该产生式推出的首个终结符的集合
- SELECT(X→α) = FIRST(α) - {ε}
- SELECT(X→ε) = FOLLOW(X)
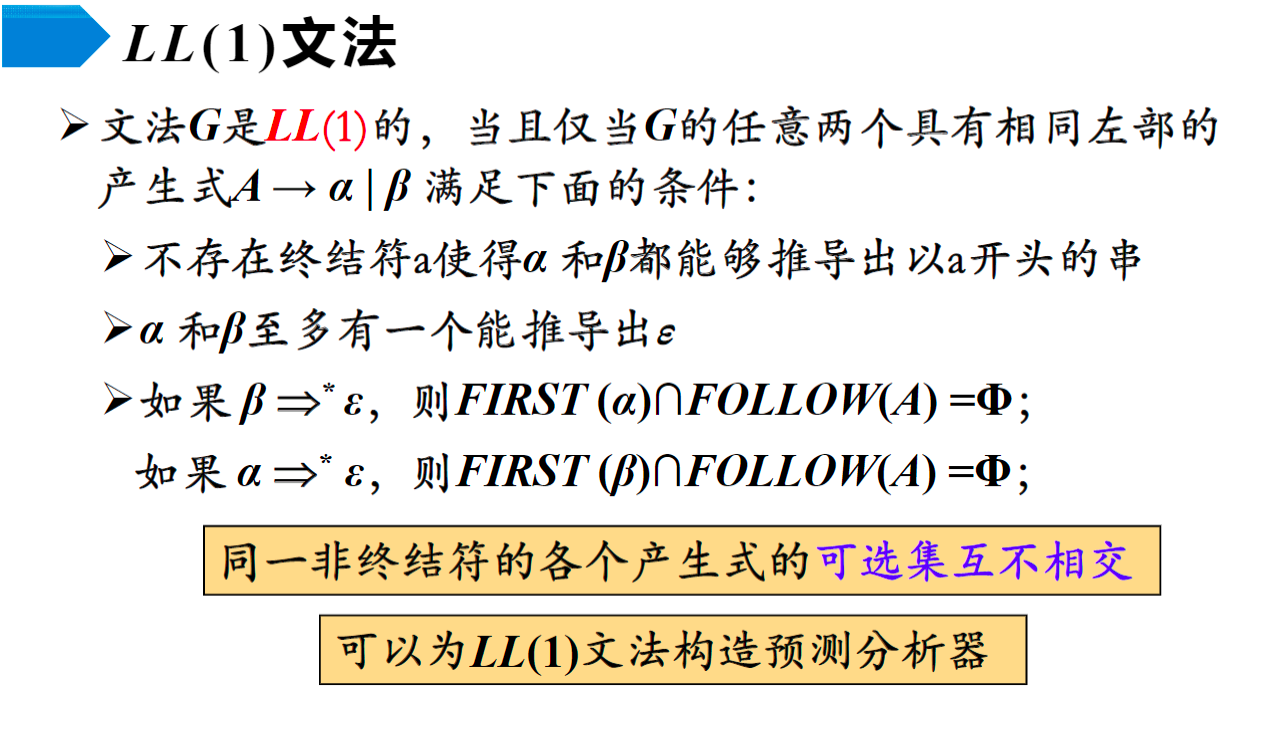
## LL(1)文法
## 预测分析
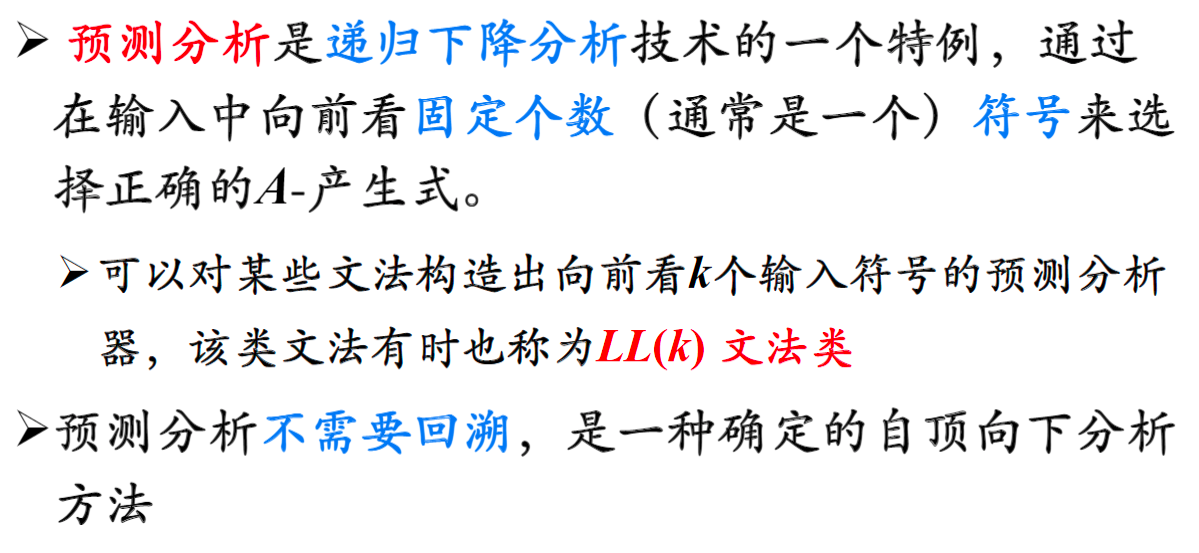
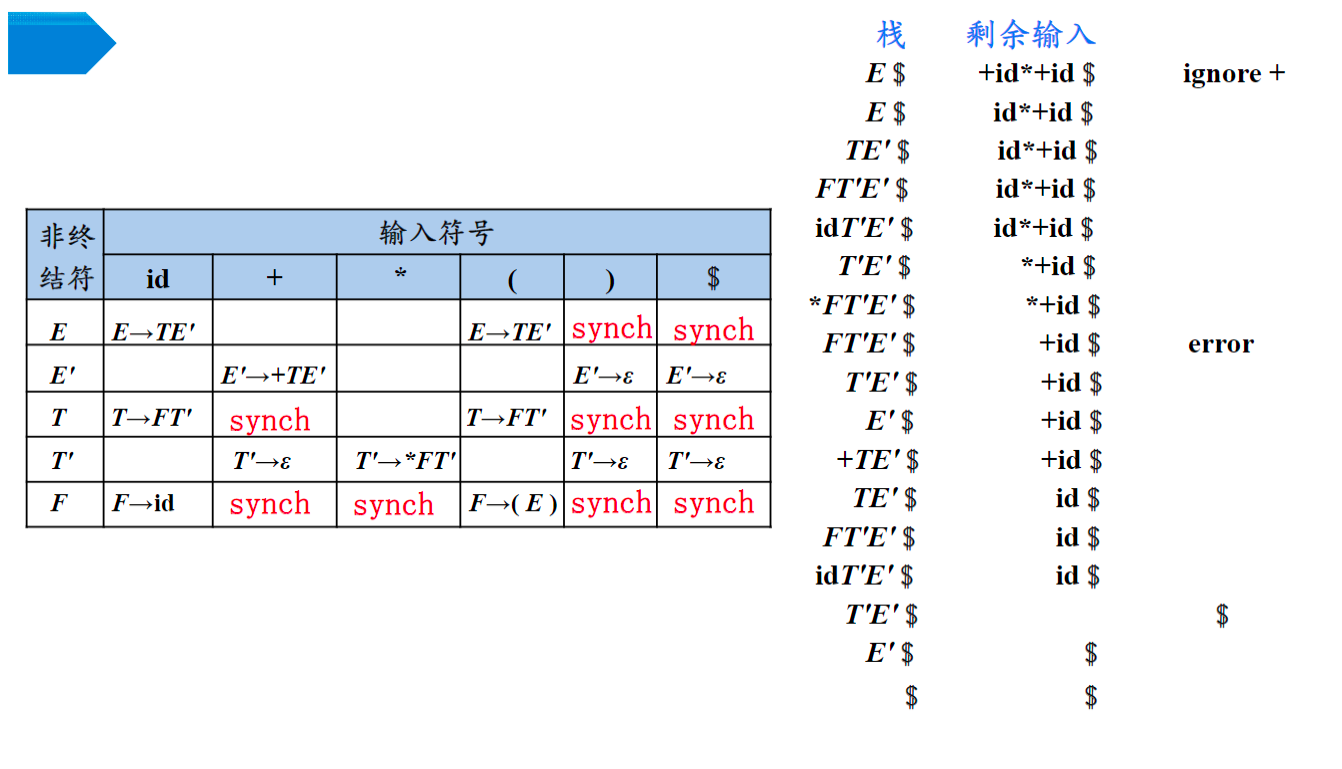
对LL(1)文法,可以构建预测分析表,其中列为输入字典的枚举,行为非终结符的枚举,单元格值代表目标推导过程的产生式
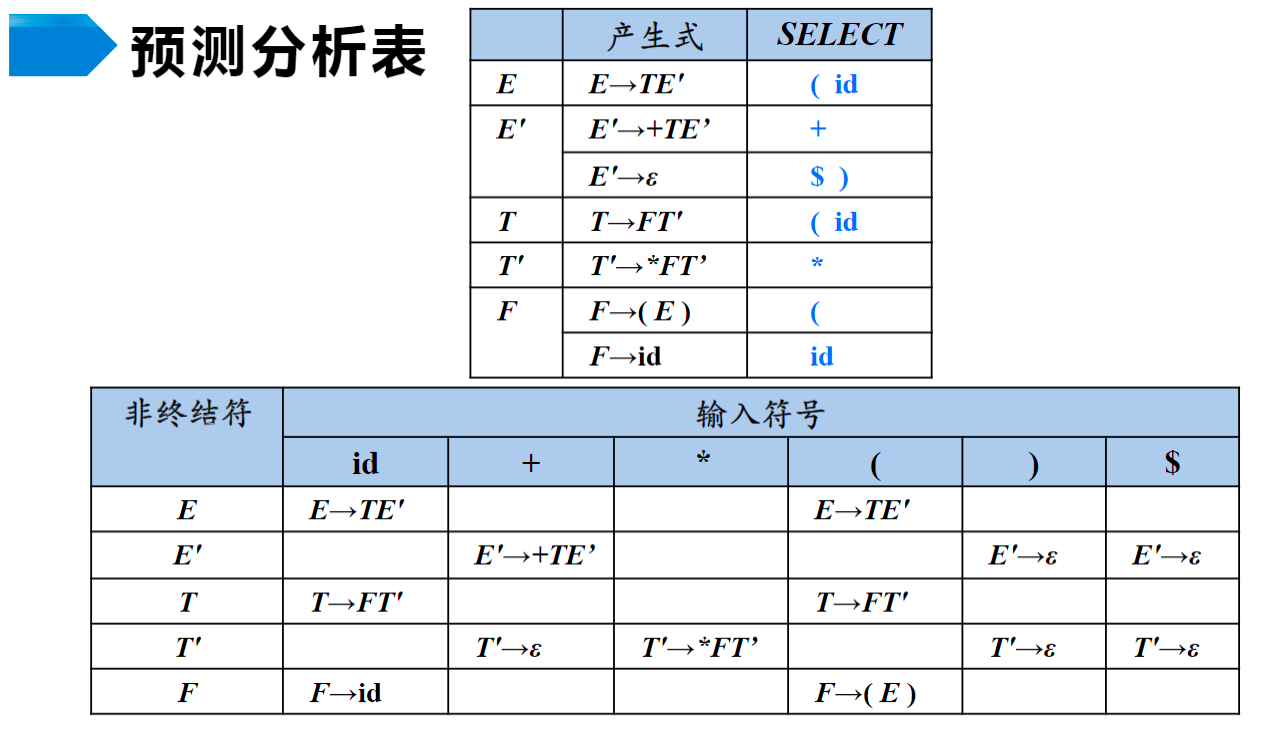
基于预测分析表和带有无穷栈的下推自动机,可以实现一个基于状态转移的预测分析:(如果不使用,则需手动实现基于规则的递归分析)
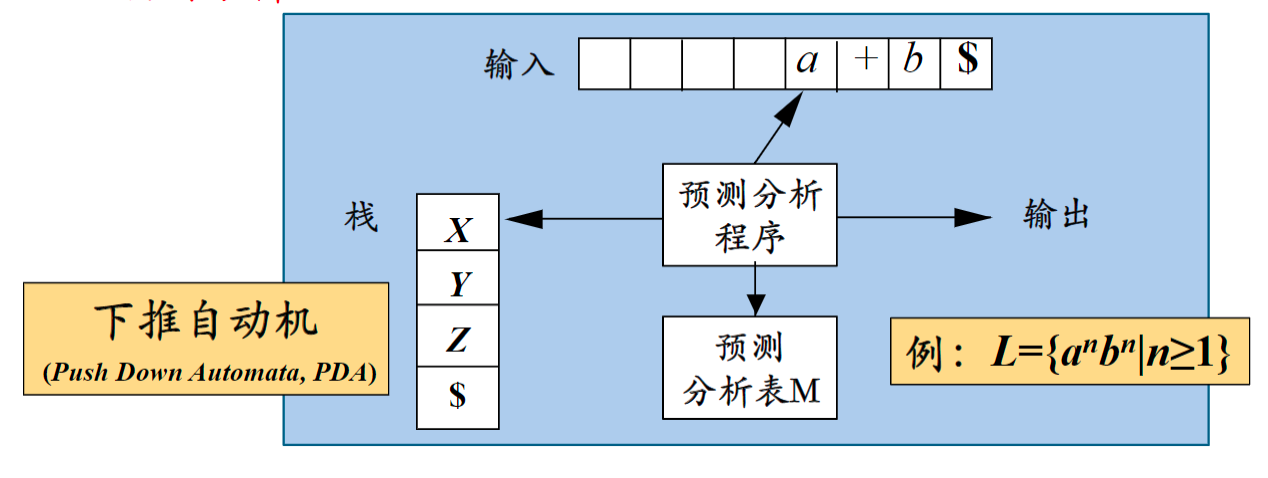
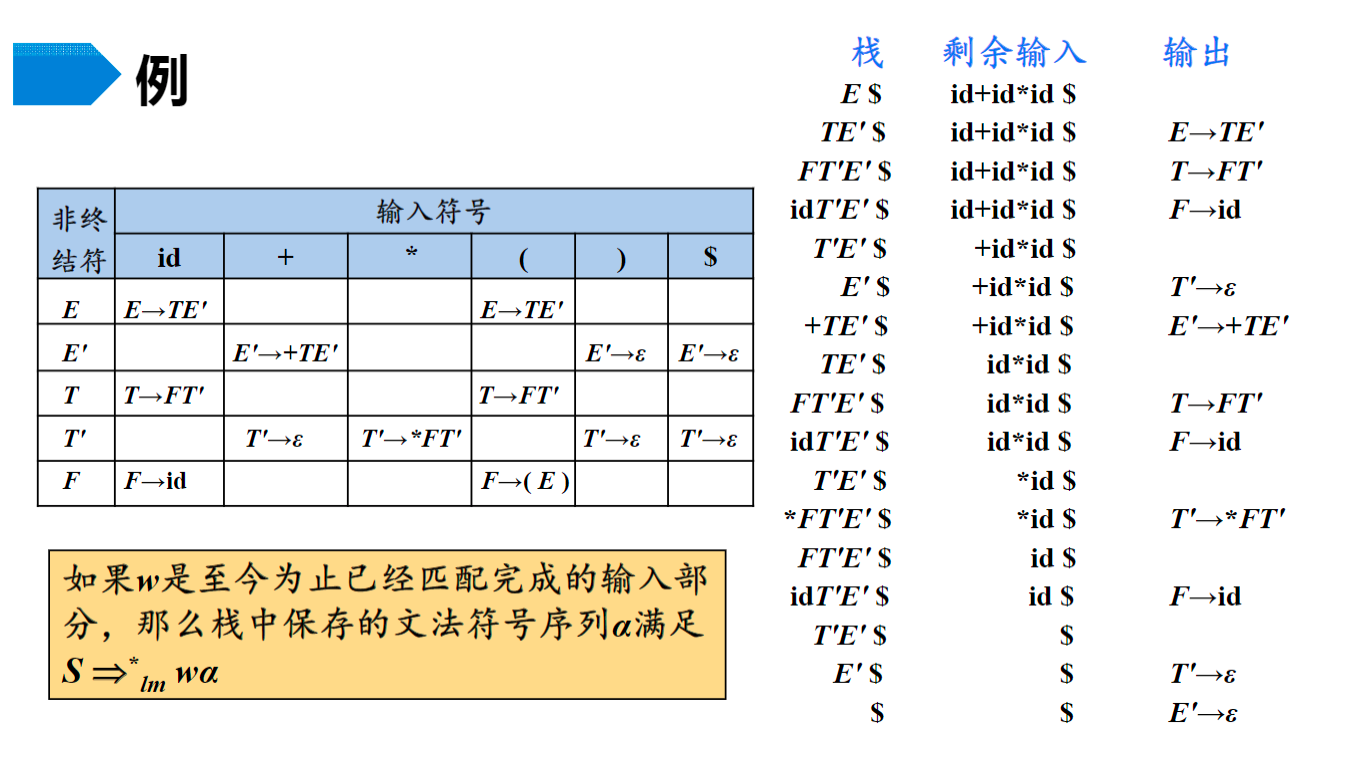
如下是使用一个栈和一个队列(即一个下推自动机)实现的预测分析/自动推导过程:
## 预测分析的错误处理
- 恐慌模式:忽略不能匹配的输入符号,直接匹配下一个输入符号(并报错)
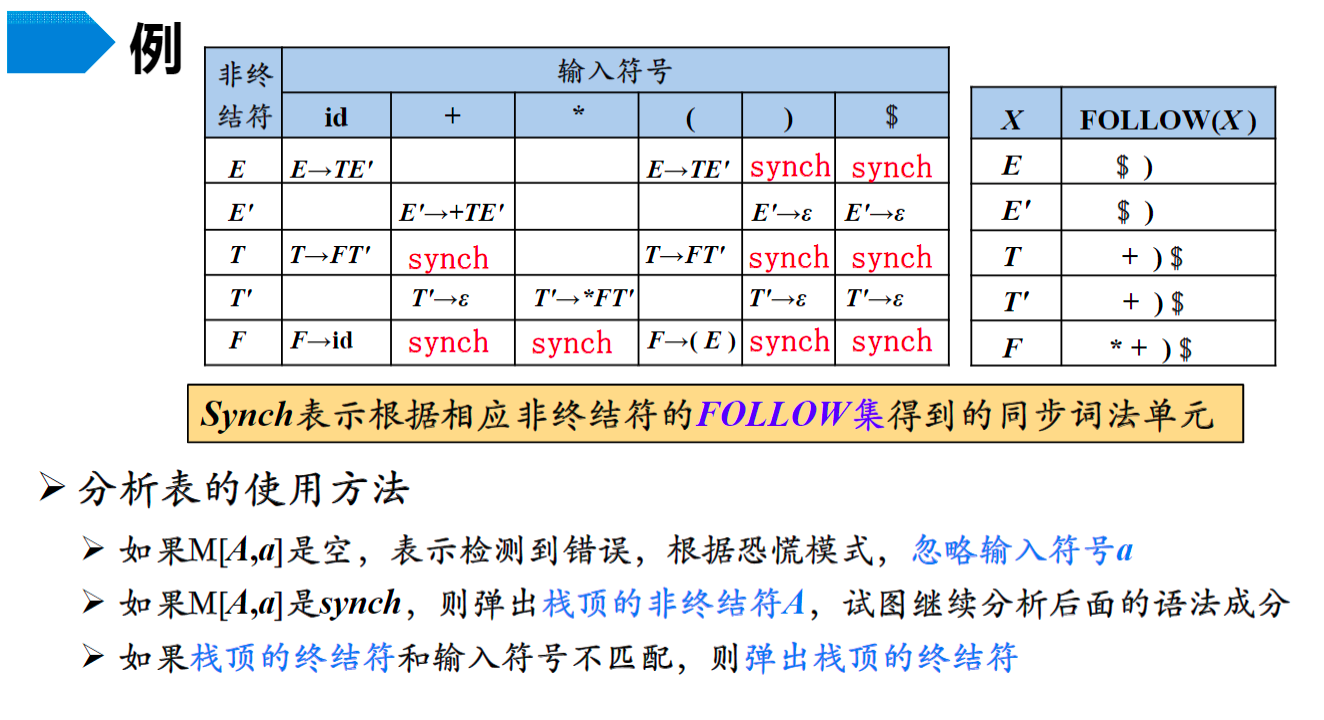
- 同步符号集:在推导某个非终结符时,若当前输入符号恰好是该非终结符对应的同步符号集中的元素,则强行终止此非终结符的推导,直接进入下一个文法符号的推导(并报错)。常取FOLLOW集中的元素作为一个非终结符的同步符号集
- 如果终结符在栈顶不能匹配,常用方法直接将其出栈(并报错)
综合上述方式,对LL(1)文法的预测分析可做如下错误处理方案:
![]()