# LINE算法
LINE算法是一种基于图的深度学习算法,用于学习节点的嵌入向量。LINE算法主要的思想是通过最小化一定的损失函数来学习节点的嵌入向量,从而实现节点之间的相似度计算、社区发现等任务。
LINE算法有两个关键的思想,分别是一阶相似度和二阶相似度。一阶相似度是指两个节点之间的直接连接,而二阶相似度则是指两个节点之间的间接连接,即它们之间存在共同的邻居节点。
LINE算法的学习过程分为两个阶段:一阶近邻嵌入和二阶近邻嵌入。
## 一阶近邻嵌入
对于一个节点$v_i$,我们定义其一阶邻居节点集合为$N^{(1)}(v_i)$。在一阶近邻嵌入阶段,我们学习到的节点嵌入向量主要是通过最小化一阶相似度损失函数来实现的。具体地,我们希望节点$v_i$和其一阶邻居节点集合$N^{(1)}(v_i)$��间的相似度更高,因此,可以使用下面的损失函数来学习节点$v_i$的嵌入向量:
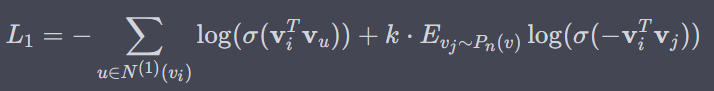
## 二阶近邻嵌入
在一阶近邻嵌入的基础上,我们进一步学习到节点的二阶近邻嵌入。对于节点$v_i$和其一阶邻居节点$N^{(1)}(v_i)$,我们可以找到它们之间的所有边,这些边连接了节点$v_i$和$N^{(1)}(v_i)$中的所有节点,从而形成了一个子图。我们的目标是学习到节点$v_i$和$N^{(1)}(v_i)$的嵌入向量,使得子图中的边权重与嵌入向量的内积尽可能接近。具体地,我们可以使用下面的损失函数来学习节点$v_i$和其一阶邻居节点的嵌入向量:
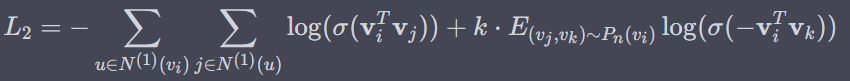
其中,$\sigma(x)$表示sigmoid函数,$k$是负采样的数量,$(v_j,v_k)$是以节点$v_i$和$v_j$的二元组为中心的负样本采样分布,$E_{(v_j,v_k)\sim P_n(v_i)}\log(\sigma(-\mathbf{v}_i^T\mathbf{v}_k))$表示在负采样中,$v_i$与$v_j$之间的相似度尽可能小。
通过最小化上述的两个损失函数,我们可以学习到节点的一阶和二阶近邻嵌入向量,从而实现节点之间的相似度计算、社区发现等任务。
![]()