# 数据结构和字符串
## 并查集
并查集常用来在一组数据之间记录等价划分,如分属不同连通分量的节点集、两类物品等等。
```cpp
int parent[N] = {0};
int find(int x) {
int t = x, p;
while(parent[t] != t) t = parent[t];
while(x != t) {
p = parent[x];
parent[x] = t;
x = p;
}
return t;
}
void merge(int a, int b) {
parent[find(b)] = find(a);
}
```
- 多域并查集
- 若给出的二元关系不是等价关系,最终任务是判断给出的某二元组是否和已知的某些关系矛盾,此时引入多域并查集。
- 例如有一批异性虫子两两配对交配(谁公谁母未知),判断有没有不是异性的二元组。
- 此时有两个关系(等价关系-同性别、非等价关系-异性别)
- 若实体有$n$个,那么建立两倍大小的并查集空间$[0,n)\cup[n,2n)$,我们认为$(a,a)$为同性别,$(a,a+n)$互为异性别。对于存在的关系$(a,b)$,$(a,b+n)$和$(a+n,b)$是两个等价关系,将这两个二元组进行合并
- 例如,虫1与虫3交配,显然`~虫1性别=虫3性别`,`虫1性别=~虫3性别`
- 当关系$(k,j)$前件和后件属于同一集合时,一定是发生了矛盾
- 矛盾并查集可以扩展到多种二元关系的情况下,如:
- $A(x,y)$表示$x,y$是同类,$B(x,y)$表示$x$吃$y$,其中每条食物链必然构成形如 A-B-C-A 的环形
- 这时除了等价关系外,还存在两种二元关系:吃和被吃
- 此时可以构建三倍大小的并查集空间,$[0,n)\cup[n,2n)\cup[2n,3n)$,我们认为$x+n$代表$x$的天敌,$x+2n$代表$x$的食物;因此有$(a,b)$为同类,$(a,b+n)$为$a$等价于$b$的天敌,$(a, b+2n)$为$a$等价于$b$的食物
- 对$A(x,y)$,合并$(x,y)$,$(x+n,y+n)$,$(x+2n,y+2n)$;若$(x,y+n)$或$(x,y+2n)$已合并,则矛盾
- 对$B(x,y)$,合并$(x,y+n)$,$(x+2n,y)$,$(x+n,y+2n)$;若$(x,y)$或$(x+n,y)$已合并,则矛盾
- x带权并查集
- 多域并查集都可以用带权并查集替代
## 树状数组
树状数组维护的是前缀和
```cpp
#define lowbit(x) ((x) & (-x))
int n; ll diff[N] = {0};
void add(int x, ll k) {
while (x <= n) {
diff[x] += k;
x += lowbit(x);
}
}
ll prefix(int x) {
ll s = diff[x];
while(x -= lowbit(x))
s += diff[x];
return s;
}
```
如果从时间序列角度来考虑加减法事件的发生,可以形成一个差分前缀和,以此来解决区间加减法更新问题,即只在区间更新开始位置加差分值,在区间结束位置减差分值,只更新两个点而非区间上每个点。最终某位置的树状数组前缀和就是该位置的差分值
## 线段树
几个关键:
- `lazy`永远不影响本层值,本层值在`build`或`update`后就直接计算完毕。`pushdown`时才会用到`lazy`来处理下层值,并传递本层`lazy`给下层,留作下下层使用
- 但凡进入下层,必须`pushdown`;但凡更新下层的值,必须`pushup`
- 分类讨论区间覆盖情况后,查询和更新的起止点在递归中无需变动:
- 目标区间和节点区间无交集,直接跳出
- 目标区间完全覆盖节点区间,直接在本层处理
- 否则(不完全覆盖),下放给下层处理,也无需判断是否到左到右,因为即使有一面无交集也会由第一种情况跳出。但是要记得`pushdown/up`
- 叶子节点一定符合前两种情况之一,因此`pushdown`永远不会影响叶子节点,也就是叶子节点的`lazy`永远不会起作用,是无所谓的变量
模板:
```cpp
struct node {
int l, r;
ll v, lazy;
};
node tree[N*4]; // 线段树最深层最多有2N个叶子节点,意味着整棵树有4N容量才能存下
int n, m;
ll a[N];
void pushup(int x) {
// 时刻保证到达的层的每个节点 v 值都正确
tree[x].v = tree[x*2].v + tree[x*2+1].v;
}
void pushdown(int x) {
// 时刻保证到达的层的每个节点 v 值都正确
// lazy是给下层用的,而不给本层用
tree[x*2].v += tree[x].lazy*(tree[x*2].r - tree[x*2].l + 1);
tree[x*2+1].v += tree[x].lazy*(tree[x*2+1].r - tree[x*2+1].l + 1);
tree[x*2].lazy += tree[x].lazy;
tree[x*2+1].lazy += tree[x].lazy;
tree[x].lazy = 0;
}
// 构建线段树,处理l,r和v属性
void build(int l, int r, int x) {
if (l == r) {
tree[x] = node{l, r, a[l], 0};
return;
}
tree[x] = node{l, r, 0, 0};
int spli = (r-l)/2; // 二分
build(l, l+spli, x*2);
build(l+spli+1, r, x*2+1);
pushup(x); // x的v由子节点传递而来
}
// 查询st-ed区间值,根据节点x的l-r区间分为:
// st-ed和l-r无交集:无贡献
// st-ed包含l-r: 完全贡献,直接使用x的v
// st-ed含l,r一端: 部分贡献,下放使用子节点结果
ll query(int st, int ed, int x) {
// 不重合
if (tree[x].r < st || ed < tree[x].l)
return 0;
// 完全重合
if (st <= tree[x].l && tree[x].r <= ed)
return tree[x].v;
// 部分重合
ll res = 0;
pushdown(x); // 下放懒标记
res += query(st, ed, x*2);
res += query(st, ed, x*2+1);
return res;
}
// 更新st-ed区间值,根据节点x的l-r区间分为:
// st-ed和l-r无交集:不更新
// st-ed包含l-r: 批量更新x的v,然后除叶子外记录lazy
// st-ed含l,r一端: 下放给子节点更新
void update(int st, int ed, int k, int x) {
// 不重合
if (st > tree[x].r || ed < tree[x].l)
return;
// 完全重合
if (st <= tree[x].l && ed >= tree[x].r) {
tree[x].v += k * (tree[x].r - tree[x].l + 1);
tree[x].lazy += k;
return;
}
// 部分重合
pushdown(x); // 下方之前的东西
update(st, ed, k, x*2);
update(st, ed, k, x*2+1);
pushup(x); // 向上传递v给x
}
```
## 二叉搜索树
- x Treap
- x Splay
## 字符串
- 字典树Trie
- 一图胜千言: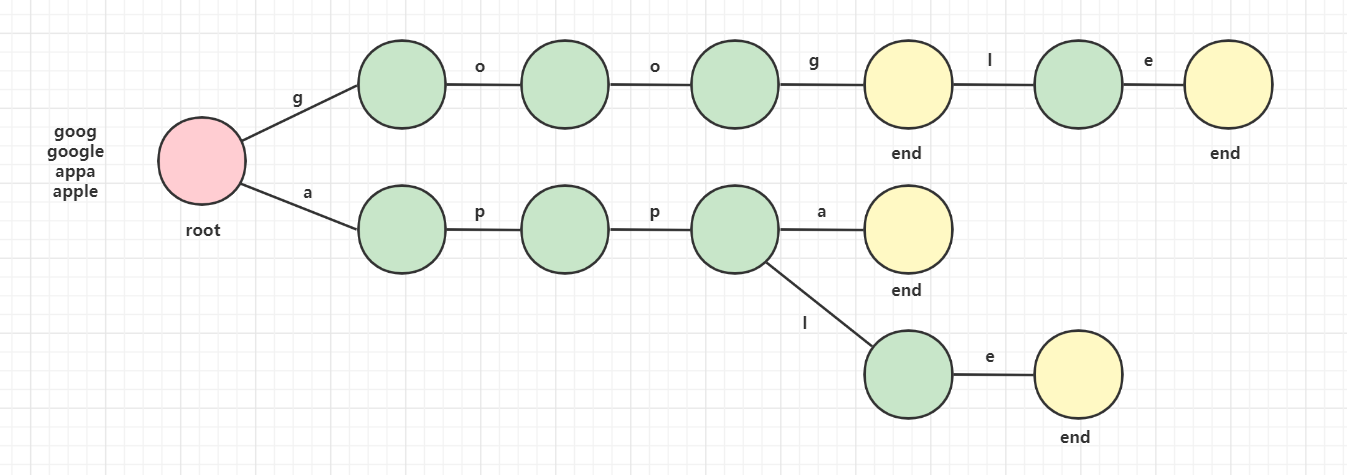
- KMP:
- 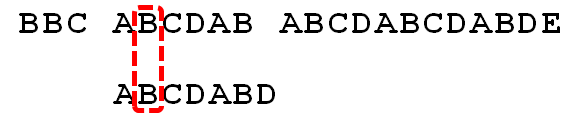
- KMP可以用于求最长公共子串,不断裁剪或旋转模式串即可
- 先模式串自己匹配自己(逐长度判断前后缀共有长度)构造Next数组,然后模式串再匹配目标串(匹配双头前进,失配模式串回跳,模式串匹配完结束)
- 代码直接背
```cpp
int next[N] = {0};
void getFail(string p) {
for(int i = 1; i < p.length(); i++) {
int j = next[i];
while(p[i] != p[j] && j) j = next[j];
if (p[i] == p[j]) next[i+1] = j+1;
}
}
bool KMP(string s, string p) {
int j = 0;
getFail(p);
for(int i = 0; i < s.length(); i++) {
while(s[i] != p[j] && j) j = next[j];
if (s[i] == p[j]) j++;
if (j == p.length()) return true;
}
return false;
}
```
- x AC自动机
- x 后缀数组
- x 字符串哈希
![]()