# DeepWalk、Node2Vec、SkipGram
## 随机游走
随机游走是一种用于生成节点序列的技术,常用于图嵌入算法中。具体来说,随机游走从一个起始节点开始,在每个时间步中以一定的概率选择一个当前节点的邻居节点作为下一个节点,直到达到预定的序列长度或满足其他停止条件。
下面是一种基本的随机游走算法:
选择一个起始节点作为当前节点,初始化节点序列为该节点。
在每个时间步中,根据一定的概率选择当前节点的一个邻居节点作为下一个节点。具体来说,可以采用以下两种策略之一:
- 均匀采样策略:在当前节点的所有邻居节点中,随机选择一个作为下一个节点。
- 概率采样策略:根据当前节点与邻居节点之间的相似度或距离,计算每个邻居节点被选择的概率,从而选择下一个节点。
将选择的下一个节点加入节点序列中,作为新的当前节点。
重复步骤2-3,直到达到预定的序列长度或满足其他停止条件。
在实际应用中,随机游走算法可以根据具体的需求进行适当的修改,例如增加节点和边的偏好、引入随机跳出策略等,以更好地探索图中的结构信息。随机游走算法在DeepWalk、Node2vec等图嵌入算法中被广泛应用。
## DeepWalk
DeepWalk是一种基于随机游走的图嵌入算法,用于将图中的节点映射到低维向量空间中。DeepWalk算法分为两个主要步骤:随机游走和SkipGram模型的训练。
首先,DeepWalk算法通过随机游走生成节点序列,这个过程类似于在图中进行随机漫步。具体来说,从图中的每个节点开始,随机游走器按照一定的概率向该节点的邻居节点前进。这个过程可以持续多次,产生一系列的节点序列。
接下来,DeepWalk算法使用SkipGram模型对节点序列进行训练,以学习节点的向量表示。SkipGram模型是一种基于神经网络的词向量训练算法,它的主要思想是通过学习一个节点在序列中的上下文信息来推断该节点的向量表示。在DeepWalk中,节点序列可以看做是类似于自然语言中的句子,节点之间的关系可以看做是单词之间的关系。因此,可以将SkipGram模型应用于DeepWalk中,来学习节点之间的相似度,从而获得节点的向量表示。
最终,DeepWalk算法可以生成一个节点的向量表示矩阵,其中每一行代表一个节点的向量表示,而每一列表示向量的维度。这个向量表示矩阵可以用于后续的机器学习任务,如分类、聚类、链接预测和推荐等。
## Node2Vec
Node2vec是一种用于节点嵌入(node embedding)的算法,由Aditya Grover和Jure Leskovec于2016年提出。Node2vec是对DeepWalk算法的扩展,具有更灵活的控制节点嵌入方式的能力。
Node2vec算法中的可控制随机游走是通过设置控制参数$p$和$q$来实现的。具体来说,Node2vec算法在随机游走过程中,将每个节点看作是一棵树的根节点,根据控制参数$p$和$q$,采用不同的策略进行随机游走,得到一条由节点组成的序列。
具体而言,Node2vec算法中,对于当前节点$v$,考虑其相邻节点$w$,定义两个控制参数$p$和$q$,通过这两个参数来调节游走的深度和广度,即决定下一步随机游走到哪个节点:
若下一步随机游走到节点$w$是从节点$v$出发的,记为$O(v,w)=p$。这种情况下,Node2vec算法倾向于探索与当前节点$v$在同一社区的节点,即游走的深度较小。可以认为这是一种深度优先搜索(DFS)策略,会使得节点序列中相邻的节点更可能属于同一社区。
若下一步随机游走到节点$w$是从节点$v$的相邻节点出发的,记为$O(v,w)=1$。这种情况下,Node2vec算法倾向于探索当前节点$v$的邻居节点,即游走的广度较大。可以认为这是一种广度优先搜索(BFS)策略,会使得节点序列中距离较远的节点也有可能被访问到。
若下一步随机游走到节点$w$是从节点$v$的非相邻节点出发的,记为$O(v,w)=q$。这种情况下,Node2vec算法倾向于在深度和广度之间做出平衡,探索当前节点$v$的邻居节点和邻居节点的邻居节点。这样可以保证节点序列中既有相邻的节点,也有距离较远的节点。
通过上述控制参数$p$和$q$,Node2vec算法可以灵活地控制随机游走的深度和广度,得到不同类型的节点序列,以适应不同的节点嵌入学习需求。同时,这种方法也可以避免随机游走陷入局部极值,获得更好的节点嵌入结果。
## SkipGram
见NLP中的Word2Vec。
## 附:Node2Vec中特殊的节点相似度计算方法(Common Neighbor)
在Node2Vec算法中,边权重是通过引入控制参数$p$和$q$来计算的,控制参数$p$和$q$定义了随机游走的策略��可以控制游走的深度和广度。具体地,对于每个节点$v$,我们从其邻居节点中以一定的概率$p_{v,x}$选择一个节点$x$,然后以一定的概率$q_{v,y|x}$选择$x$的邻居节点$y$。边权重$w_{u,v}$表示在这样的随机游走策略下,从节点$u$到节点$v$的权重,计算公式如下:
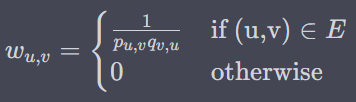
其中$p_{u,v}$表示从节点$u$到$v$的转移概率,$q_{v,u}$表示从$v$返回到$u$的转移概率。根据控制参数$p$和$q$的不同取值,$w_{u,v}$的值也会发生变化,从而影响节点之间的相似度计算。
计算节点相似度时,可以使用加权的Common Neighbor方法来度量节点之间的相似性。Common Neighbor方法是一种基于邻居信息的节点相似度计算方法,它度量的是两个节点之间的共同邻居节点数量。在Node2Vec算法中,加权的Common Neighbor方法将边权重作为节点邻居的权重,用于计算节点之间的相似度。具体而言,假设节点$v$和$u$的邻居节点分别为$N_v$和$N_u$,则它们的相似度可以通过下面的公式计算:
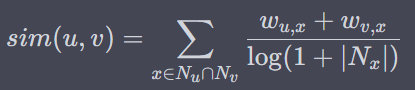
其中$|N_x|$表示节点$x$的邻居数量。$w_{u,x}$和$w_{v,x}$表示节点$u$和$v$与$x$之间的边权重,$\log(1+|N_x|)$是对节点$x$邻居数量的归一化,防止度量结果受邻居数量的影响。通过这种方式计算节点之间的相似度,可以得到更准确的节点嵌入向量。
![]()