# 双塔模型入门(DSSM)
## 介绍
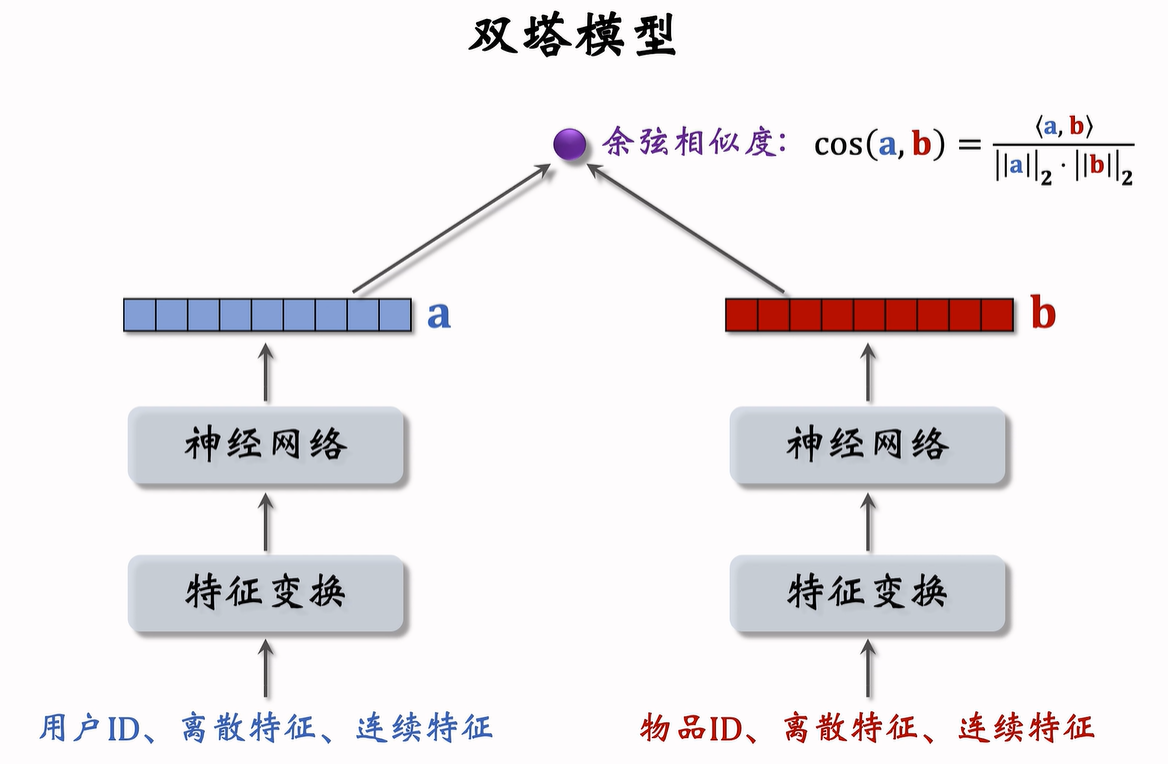
基本结构:引入带有深度神经网络的“塔结构”,将包含ID在内的多种特征经过变换、嵌入再投入附加的神经网络,最终生成统揽所有特征的向量。分别构建用户和物品两组特征向量,���证两组向量维数相同,然后通过融合训练,使用户和物品尽可能处于同一个语义空间中(比如使用户与值得推荐的物品余弦相似度接近1)。如下图所示:
## 训练方法
### 正负样本选择
样本:这里特指**用户-物品二元组$<u,i>$**
正样本:直接选择用户和其有交互的物品
负样本:
- 简单负样本:用户与全体物品里随机抽选的物品构成负样本,可以乘以一个热门惩罚,使得热门物品更容易被选到(因为一般的内容系统里冷门物品基数过大)
- batch内简单负样本:分批情况下,一个用户与该批内其他用户交互过的物品构成负样本;为了平衡冷热门物品,可以用 $cos(u,i)-\log_k{p_i}$ 作为且仅作为训练时的损失函数,其中 $p_i$ 为该物品的热门指数(如点击次数),$k$ 为超参数
- 困难负样本:以往进入召回层,但在排序层被筛除的样本
- 可考虑 简单:困难 比例为 1:1
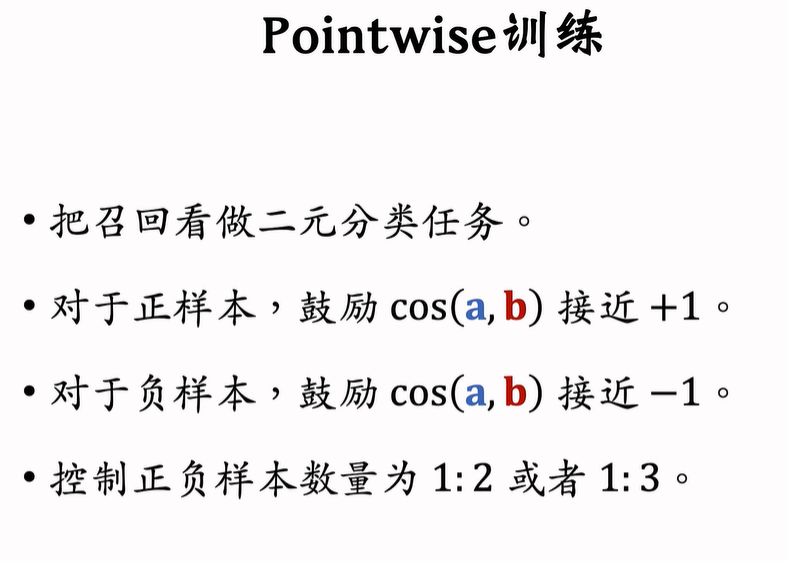
### Pointwise(单物品,单用户)
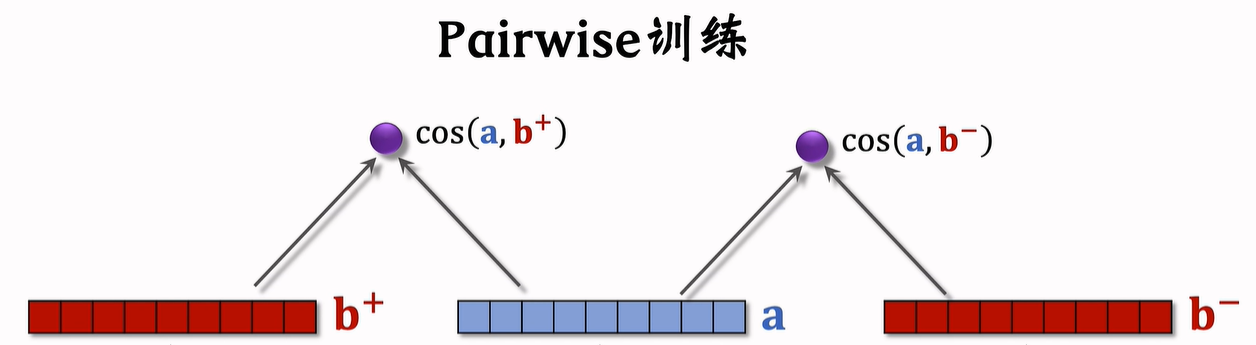
### Pairwise(单正样本物品,单负样本物品,单用户)
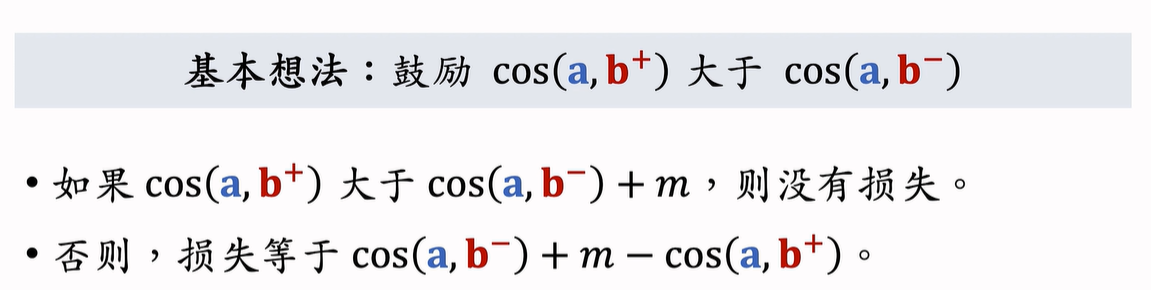
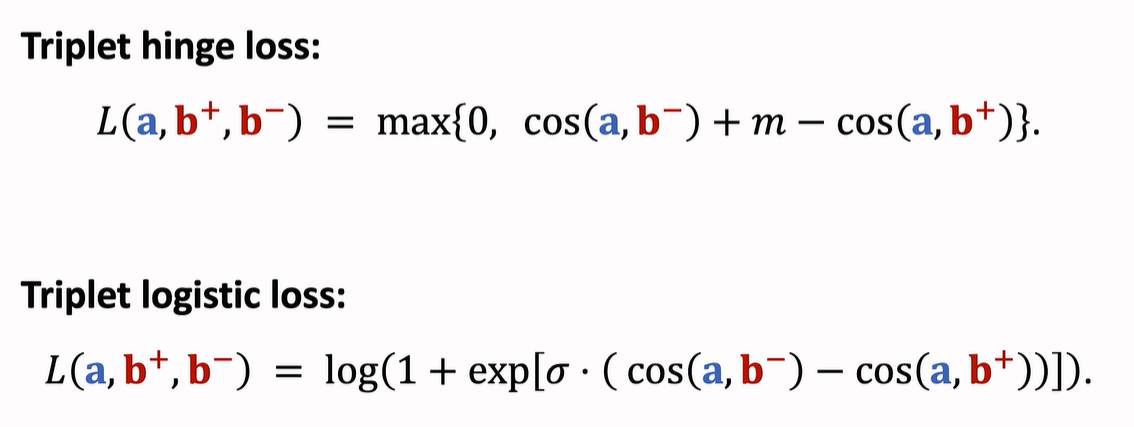
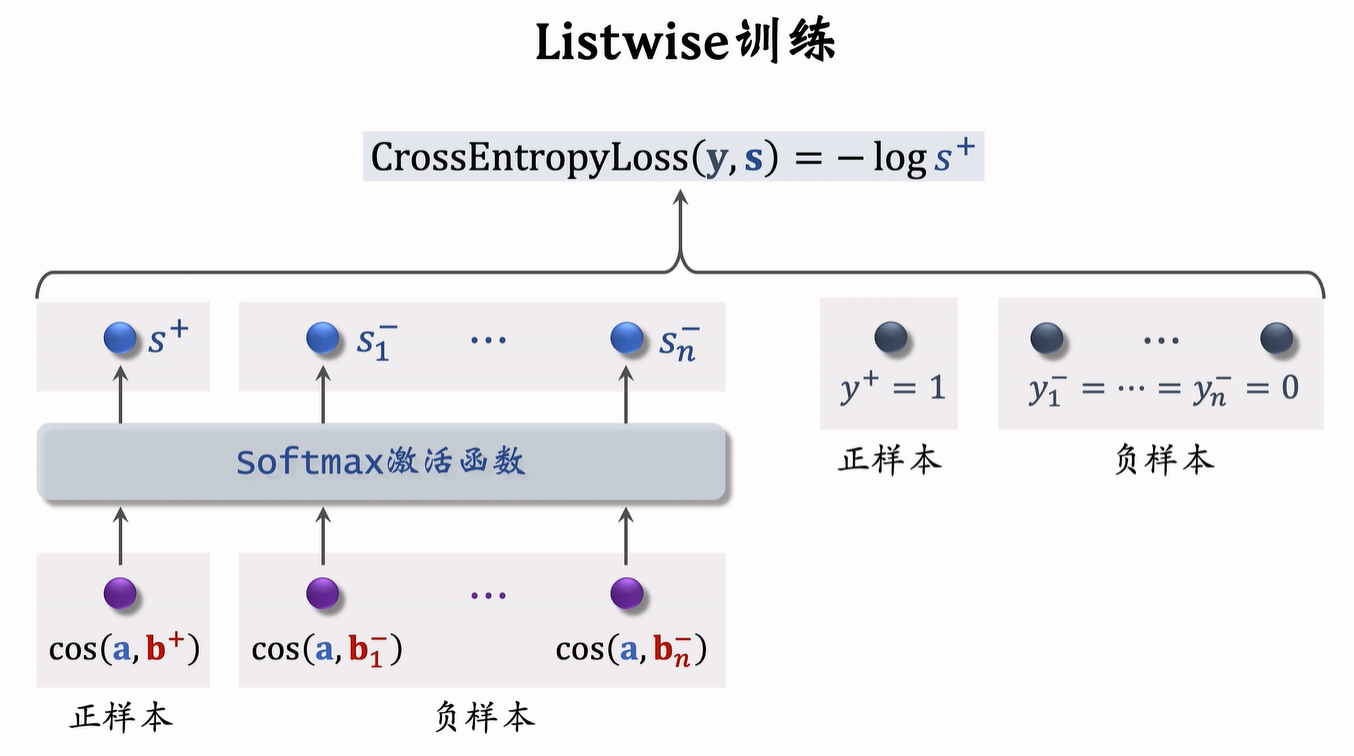
### Listwise(单正样本物品,多负样本物品,单用户)
![]()