# 基于物品和用户的协同过滤推荐 / 基于内容的推荐
## 基于内容的推荐
最简单的一种推荐,直接把用户和物品置于同一个语义环境下,直接计算近邻
实现方法比较朴素,最典型的一种是通过记录用户行为,将用户和物品置于同一个向量空间中,直接计算近邻。
比如每个物品都有6选2个标签,而每位用户有对这6个标签的倾向,物品和用户就可以直接使用6维向量计算相似度。
## 基于物品的协同过滤(ItemCF)
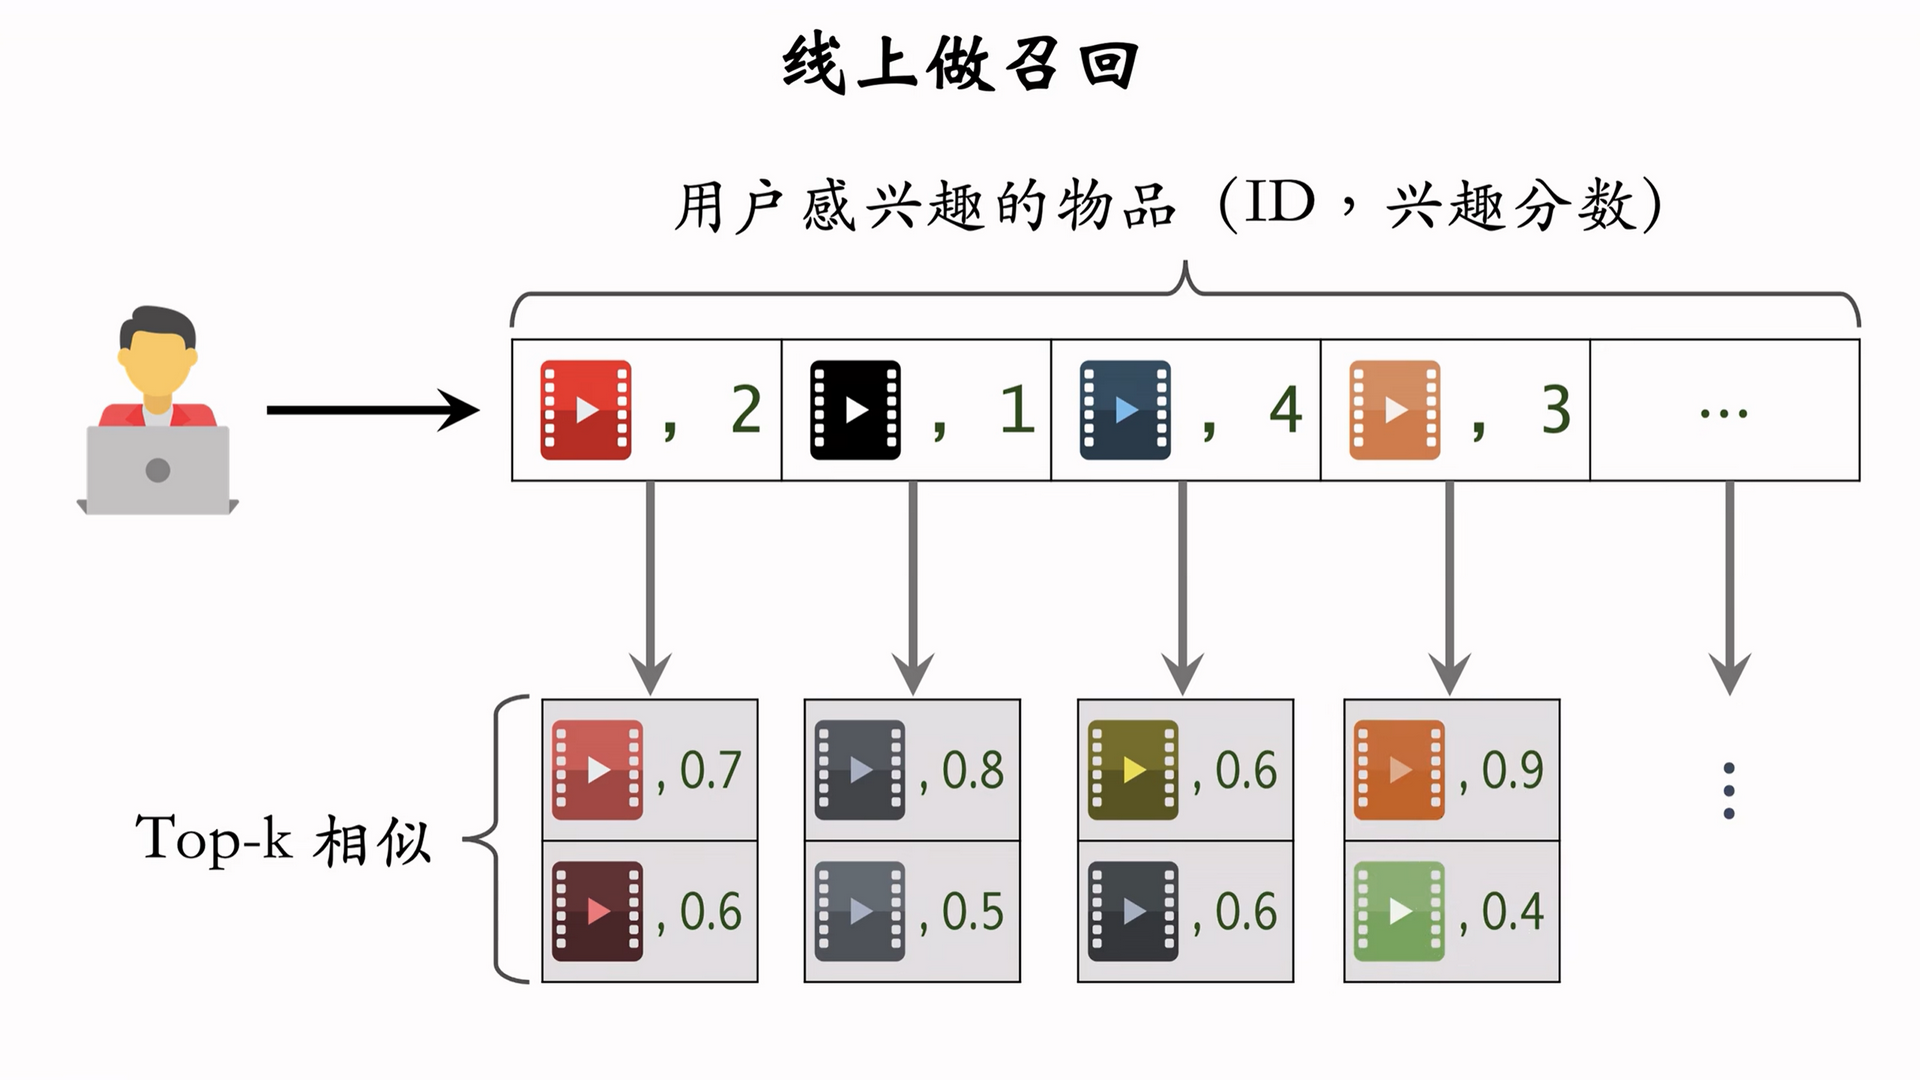
```
交互 相似
人 --------> 物 --------> 物(推荐目标)
```
实现方法:
- 维护两个索引:人交互于物、物相似于物
- 召回时,首先在人交互于物索引中找到 $n$ 个该用户最近或最常交互的物品集合 $I = \{I_1, I_2, \dots, I_n\}$ 及其**交互分数** $S_I = \{S_{I_1}, S_{I_2}, \dots, S_{I_n}\}$
- 对每一个 $i \in I$,在物相似于物索引中找到前 $k$ 个与其最相似且用户未与之交互过的物品集合 $T_i = \{T_{i1}, T_{i2}, \dots, T_{in}\}$ 及其**相似度分数** $S_{T_i} = \{S_{T_{i1}}, S_{T_{i2}}, \dots, S_{T_{in}}\}$,这就是召回的目标物品
- 对所有的目标物品 $T_{ij} (i = 1, 2, \dots, n; j = 1, 2, \dots, k)$,有**综合分数** $S_{ij} = S_{I_i} \cdot S_{T_{ij}}$
- 然后对综合分数降序排序去前面一部分即可
物相似于物索引中,相似度的计算:
- 最简单的方法是基于内容
- 较为实践化的方法是基于共同交互用户,即对物品 $A$ 和 $B$,与其交互过的用户集合定义为 $U_A$ 和 $U_B$,其相似度为 $\displaystyle\frac{|U_A \cap U_B|}{\sqrt{|U_A|\times |U_B|}}$,加入交互分数 $S(user, item)$则为 $\frac{\displaystyle\sum_{u \in U_A \cap U_B}S(u, A)\times S(u, B)}{\sqrt{\displaystyle\sum_{v \in U_A}S^2(v, A)}\space\dot\space\sqrt{\displaystyle\sum_{w \in U_B}S^2(w, B)}}$
- 另有一种考虑用户间社交圈的加权算法,使得同一社交圈内的用户对同样两个物品的相似度计算的影响力减弱,以此来避免越来越靠近圈子中心使得内容僵化,称为Swing。此时相似度可以为 $\displaystyle\sum_{u \in U_A \cap U_B}\sum_{v \in U_A \cap U_B}\frac{1}{\alpha + |u和v共同交互过的物品|}$ ,其中 $\alpha$ 为超参数
## 基于用户的协同过滤(UserCF)
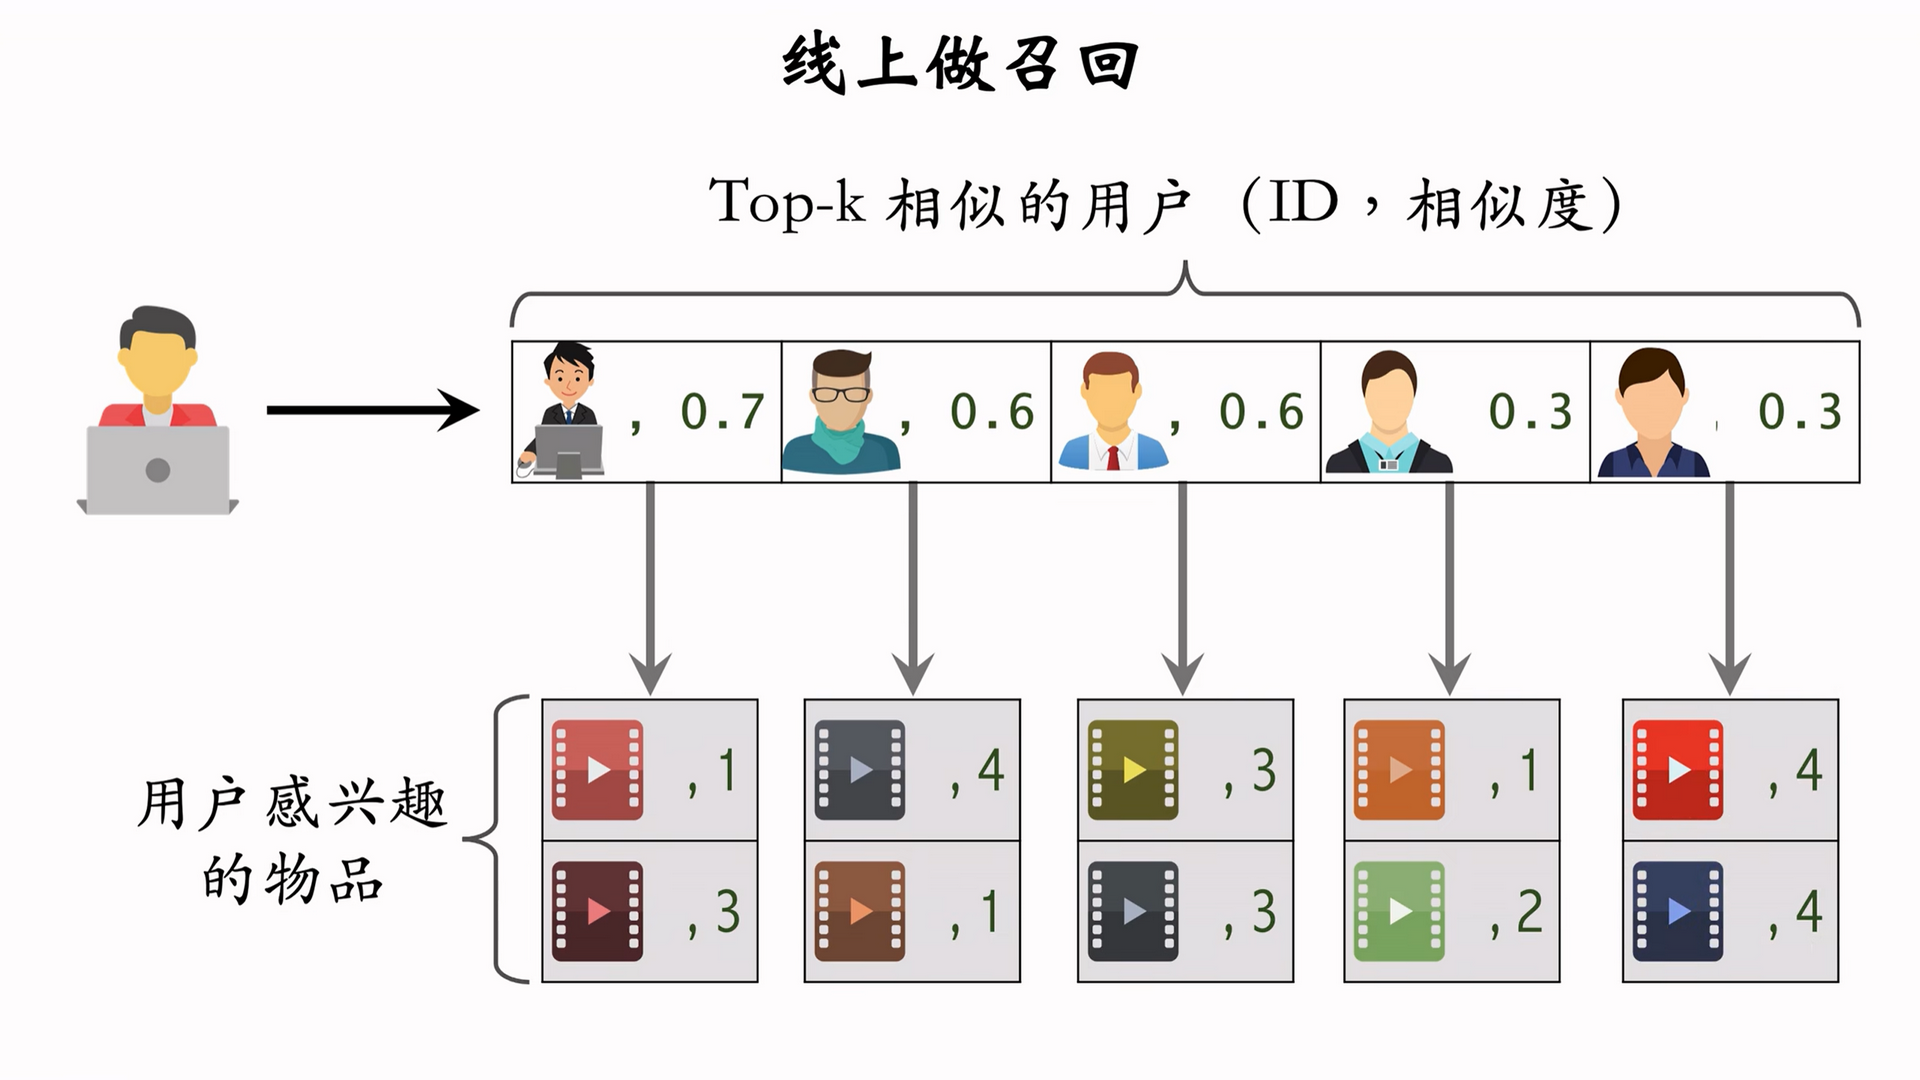
```
相似 交互
人 --------> 人 --------> 物(推荐目标)
```
实现方法(略):
- 维护两个索引:人相似于人,人交互于物
- 召回时,先找到一些与用户相似的人及其相似度分数,再找每个相似的人深度交互过的物品及其交互分数,然后将相似度分数与交互分数相乘,得到每个物品的综合分数,降序排列后截取一部分
人相似于人索引中,相似度的计算:
- 最朴素的方法是将人标签化(即基于内容的方法)
- 交互相同物品的个数也可作为相似度的指标,然后使用两人各自的交互物品个数做归一化(参考ItemCF计算物相似于物的相似度)
- 另可考虑降低过于热门的物品的权重,即对两人都交互过的所有物品 $I$,使用 $\displaystyle\sum_{i\in I}\frac{1}{\log n_i}$作为相似度的指标,再使用两人各自的交互物品个数做归一化(参考ItemCF计算物相似于物的相似度)
![]()