# 微服务架构简介
当我们依据产品定义开发软件系统时,随着用户访问数量的增加,单台服务器硬件的计算和存储能力将无法满足产品需求。这时我们就会试图拆分软件系统到不同的硬件服务器中,以增加系统整体计算和存储能力。这种行为称为对软件系统的分布式操作。微服务的概念就是由此产生——将一个服务拆分为多个更小的服务,从而可以将服务放入到更多的硬件中,或者将不经常使用的服务合并到一个硬件——通过增加或减少系统硬件,调节系统整体的承载能力。
既然是拆分服务那么首先要了解服务是如何构成的。一个典型的Web services是一个能够处理多个http请求的服务端软件系统。例如在spring boot下每个http请求被放入到controller目录里面。在nodejs的express框架下被放在routes里面。而在更早以前对服务的定义是由能够被消息触发的任务所构成的软件系统。
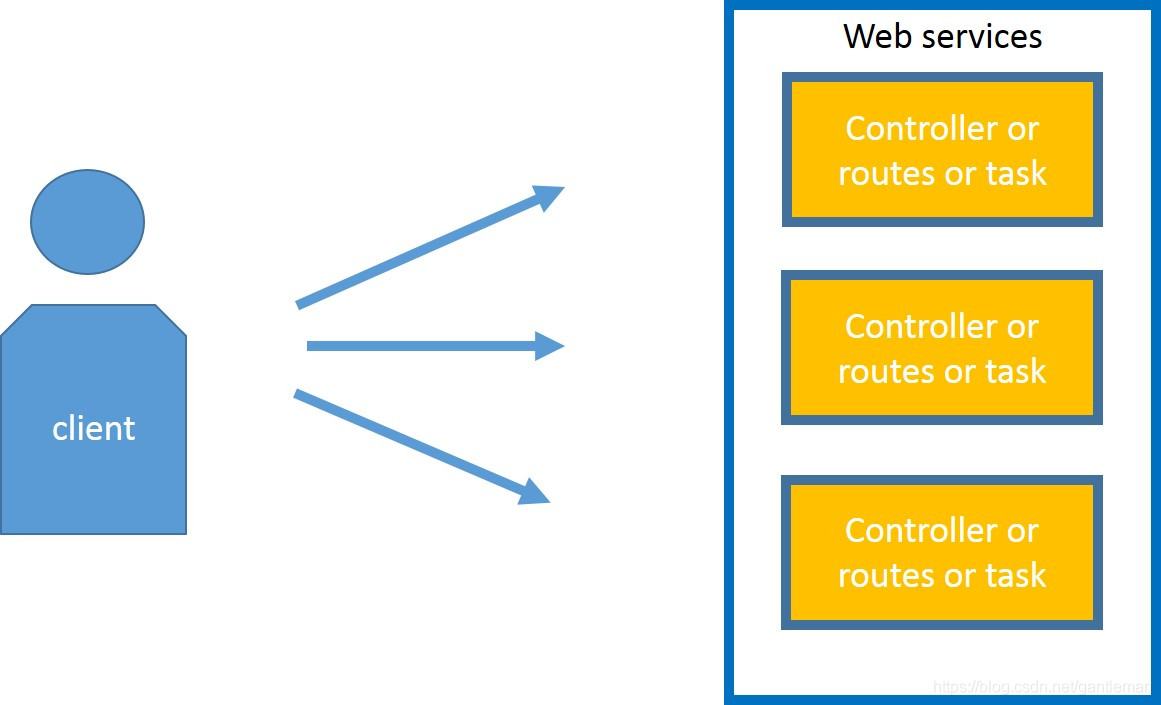
我们知道,服务是由多个任务构成的,这些任务分别属于不同的产品功能。虽然他们都被放在同一个服务内,但是彼此间有的关系较为密切,有的则看起来毫无关系。当任务多到难以理解的时候,人们引入了另一个概念“产品功能”来帮助划分任务的类别。**产品功能仅仅是帮助人们在软件开发中记忆及沟通交流的辅助工具,不能用作微服务拆分的标准。**
进行微服务拆分的第一步是消除任务之间的时序和数据的耦合。任务私有数据与私自交换数据将会导致任务的时序问题,即任务的执行顺序产生依赖关系。例如,购买商品的任务直接将数据传递并触发支付的任务,并等待支付任务的完成,就是一种任务之间的时序依赖关系。消除这种互相依赖的耦合关系最简单直接的方法就是将**所有数据都放入内存数据库**。将数据都放入内存数据库之后,任务的执行过程就变为:1,接受消息触发。2,读取内存数据库。3,执行数据处理逻辑。4,将处理完成的数据写回内存数据库。这种消除耦合关系的方法我称为“AP”方法
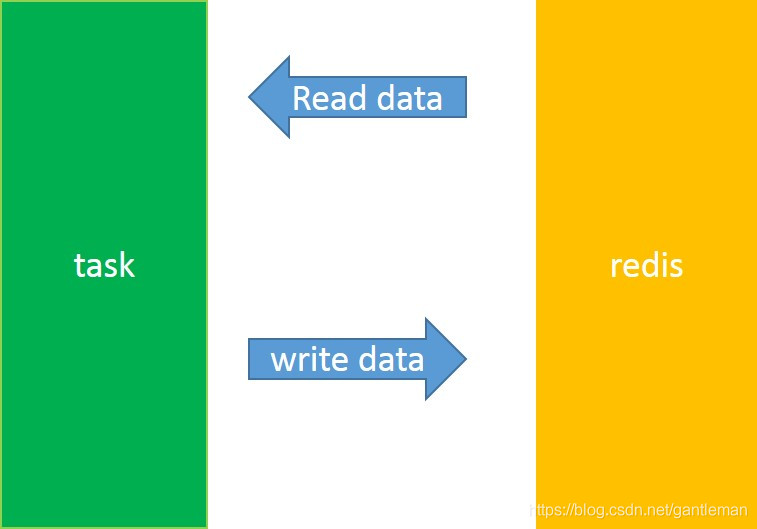
在并发编程中如果遇到有原子性需求的状况,我们需要创建一个互斥锁来保护数据的写入或读取正确。而在分布式系统中服务的容器本身就具备原子性。单线程的服务器容器,例如单线程的nginx,tomcat或web service都具有天生的原子性。也就是说这些容器本身就是互斥锁或分布式锁。任务从内存数据库读取和写入数据的过程也具有了天然的事务性。在任务计算过程中不会存储到内存数据库,只有任务计算成功后数据被提交到内存数据库才算执行成功。其间如果任务执行失败没有提交数据到内存数据库也不会污染或损坏数据。
很显然具有原子性关系的任务不能拆分到不同的容器。而没有原子性关系的任务可以拆分到不同的容器。例如我们有任务“A,B,C”。分别写入数据“A{pants, skirt, coat},B{Jeans,coat},C{hat , glove}”。显然因为A和B都需要写入数据“coat”所以任务AB具有原子关系只能放在相同的服务器容器内。而任务C与其他的任务没有原子关系所以不需要放在相同的容器内。进而我们可以将服务拆分为两部分。
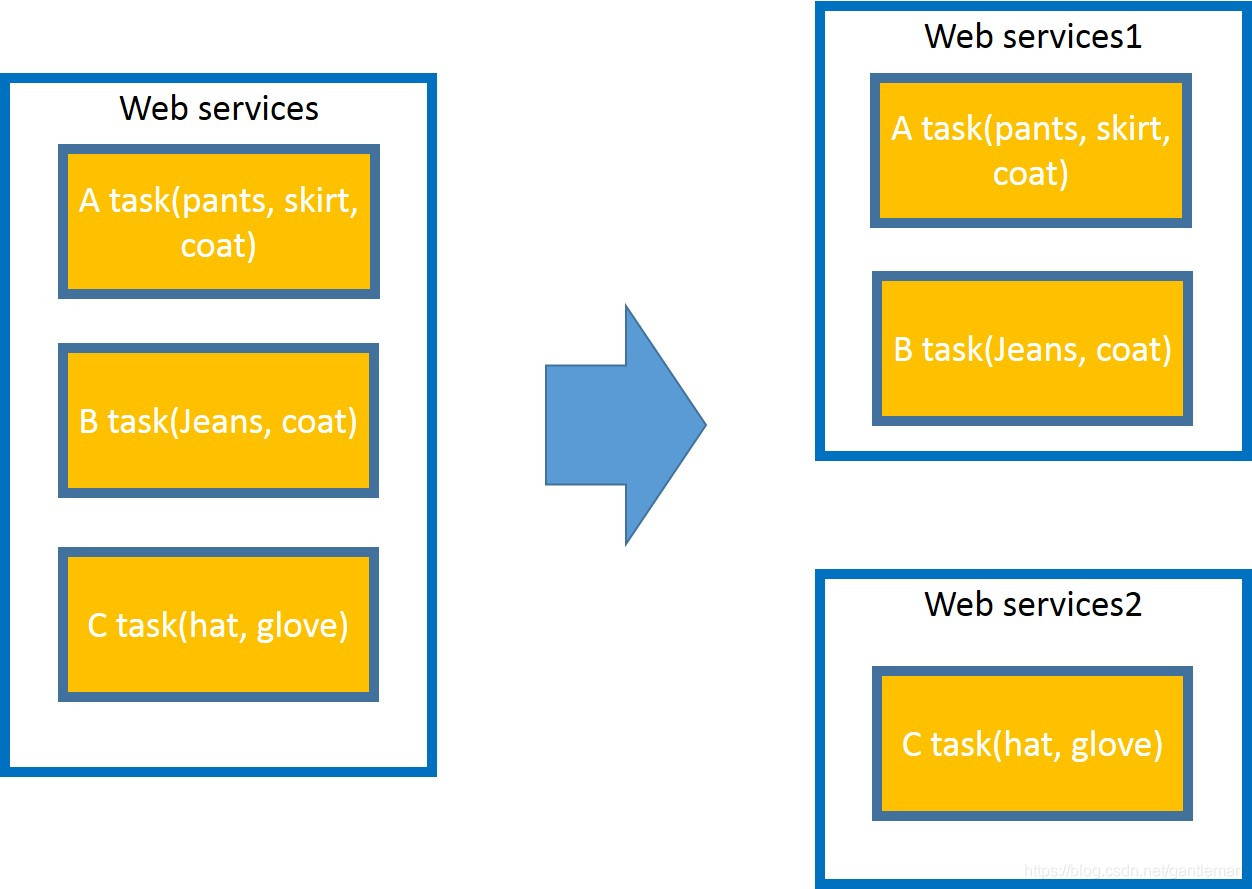
这个方法的神奇之处在于,其实你并不需要真正的把工程文件拆分两个不同的部分。只要依据写入数据的不同,在路由器对请求进行分流就可以了。
我们将**依据写入数据集的原子关系对任务进行分类并拆分**的方法称为RP方法。服务在这里像被撕裂开但是仍然互相链接,服务间维持着一种奇妙的关系。
AP&RP方法让我们用简单的方法论实现的对微服务的拆分。我想这基于如下几个方面,第一,AP&RP方法并没有试图去解决产品功能实现的问题。第二,AP&RP方法首先是将任务的时序性转为了数据性。然后通过对数据性的划分实现了系统分布。第三,AP&RP方法指出了服务容器是一个由多个潜在属性组成的复合体,其包括了原子性,事务等等。在分布式设计中要充分考虑这些潜在的复合属性所带来的影响。
---
## 总结
AP:所有数据都放入内存数据库,避免任务间的直接数据依赖,再通过消息进行流程控制,从而解除耦合
RP:通过分析共享资源的并发性,找到最小无关集进行线程拆分,从而在保证线程安全的前提下解除耦合
摘录自[分布式系统设计新手入门—1,微服务的拆分_Sur的工作日子-CSDN博客](https://blog.csdn.net/gantleman/article/details/89606705)
![]()