# 决策树
形态是多层if构成的模型
- 训练:有监督的样本集-机器学习建立决策树
- 测试:测试样本-决策树-分类结果
有 ID3(80s)、C4.5、C5.0、CART 等算法
## ID3
启发式算法,越浅的节点越应该有高区分度,更深的节点用来进一步细分
### 熵
$$Entropy(S)=-\sum^m_{i=1}p_i\log_2(p_i),\space p_i=\frac{|C_i|}{n},$$
其中类别数为$m$,样本数为$n$,样本集为$S$。
### 信息增益
信息增益是划分前的熵$Entropy$与用某属性划分后各个划分集的熵的加权平均值的差:
$$Gain(S,A)=Entropy(S)-\sum_{i=1}^{A_v}\frac{|S_i|}{|S|}Entropy(S_i),$$
其中$A$为一个属性,$A_v$为$A$可取值的枚举数。计算所有的$A$,最终取得信息增益最大的属性:
$$\displaystyle\arg\max_A Gain(S,A)$$
信息增益越大的属性节点,应该越浅,根节点一定是信息增益最大的节点。每层节点可以以递归形式计算。
**信息增益对可取值数目较多的属性有偏好**
## C4.5
引入**信息增益率**,而非信息增益:
$$
Gain\_ratio(S,A)=\frac{Gain(S,A)}{-\displaystyle\sum_{i=1}^{A_v}\frac{|S_i|}{|S|}\log_2\frac{|S_i|}{|S|}}
$$
可以修正ID3总是容易选择较多划分取值的属性的问题
## CART
### Gini指标
$$
Gini(S)=1-\sum_{i=1}^{m}p_i^2\\
Gini(S,A)=\sum_{i=1}^{A_v}\frac{|S_i|}{|S|}Gini(S_i)
$$
$Gini(S,A)$越小的$A$,区分度越强
# 决策树的相关问题
## 连续属性离散化
二元属性和枚举属性:
- ID3、C4.5将对每一个取值枚举划分
- CART永远采用二分递归分割,生成的永远为二叉树
连续属性(如数值型属性):
- 非监督:区间分段形式划分(等宽、等量、聚类)
- 监督:按区间纯度极大化来划分(CART使用Gini指标,C4.5使用熵)
## 拟合问题
- 训练误差:与训练集的拟合
- 泛化误差:对测试样本的拟合
- 训练误差高:欠拟合
- 泛化误差高(训练误差高):过拟合
- 解决过拟合:剪枝
- 预剪枝:提前判断某一个分支是否需要细分,可按层数,也可按剩余样本状况
- 后剪枝:完全划分后,再自下而上判断剪枝后错误率是否减少
- 主要使用验证集
# 集成学习(Ensemble)
形成多个模型,分别去检验一个新样本,然后这多个模型的结果进行投票(如加权平均或求和),即为集成学习。是一种优化方法。
决策树是一种弱学习、弱分类算法,经过集成可能能达到强学习的水平。
## 装袋法(Bagging)
使用同一份训练集,但每次训练**有放回**地随机抽取
## 提升法(Boosting)
使用同一份训练集多次训练,每一次都将上一次难以划分开的样本的权重增加
## 随机森林(Random Forest)
相比于装袋法,每次训练中还从$n$个属性中**无放回**随机抽取$t$个属性(一般$t=\lfloor\log_2(n+1)\rfloor$),只有这些属性可以被学习,常用于CART
# 回归树与分类树
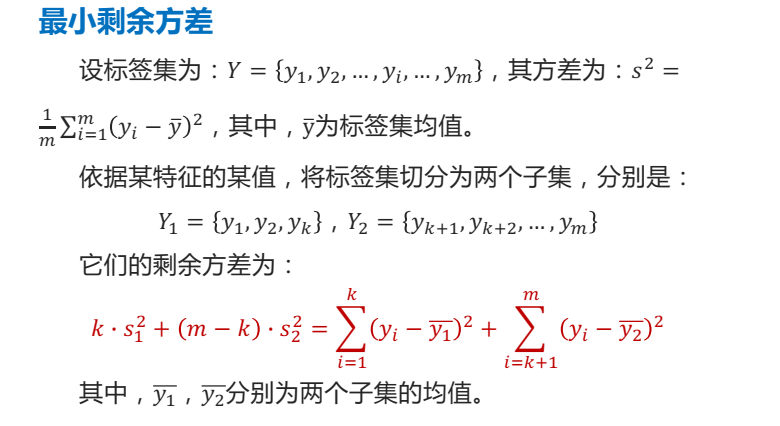
ID3、C4.5都属于分类树,结果是离散的布尔量或枚举量,如性别;而回归树的结果是数值,如年龄、身高等。回归树也是一种决策树,CART树可以用于回归,梯度提升决策树(GBDT)也是一种回归树。
## CART回归
## 梯度提升决策树(GBDT,Gradient Boosting Decision Tree)
一般使用均方差为主的损失函数,若异常值较多,也可使用绝对值损失
不断增加新的模型,以拟合老模型中的残差(与实际值的偏差),将所有模型结果的和作为最终结果。负梯度值可以作为残差的估计值。
常用XGBoost树提升系统
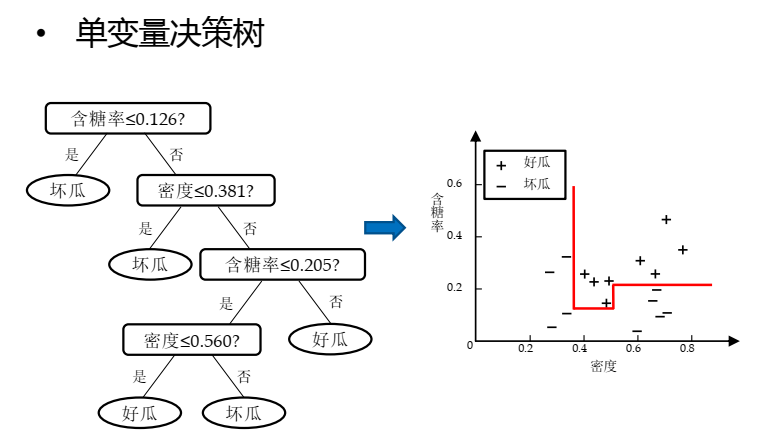
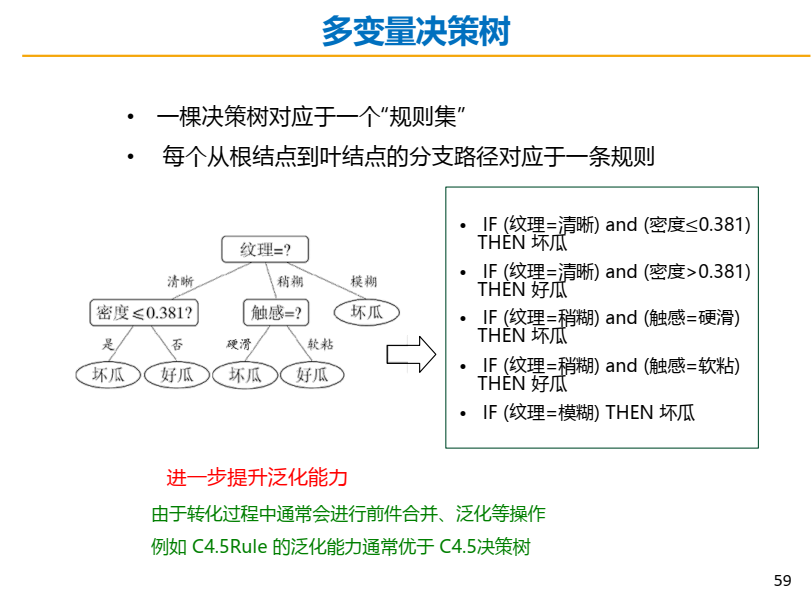
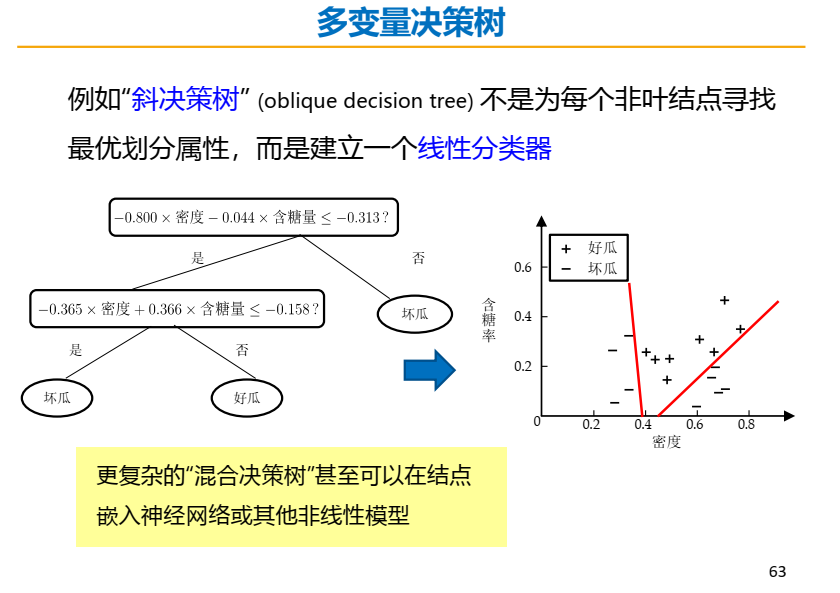
# 多变量决策树
![]()