博客 > 硬件&操作系统&网络&DevOps > 编译原理
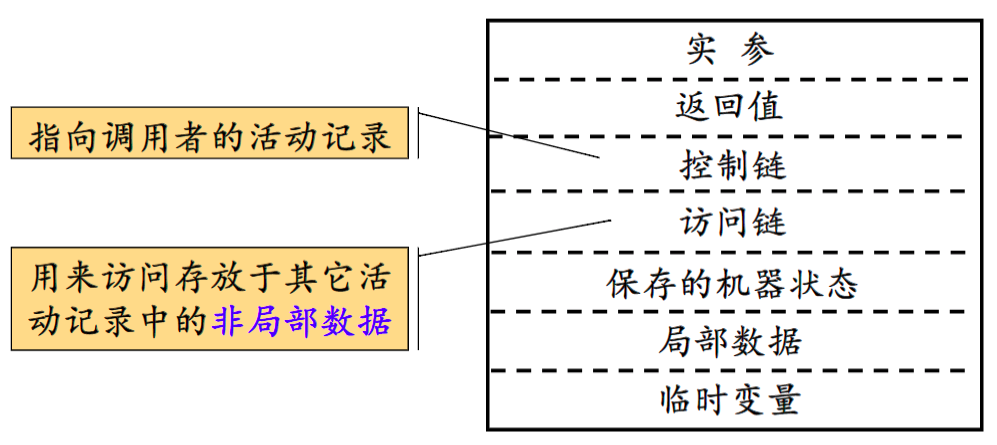
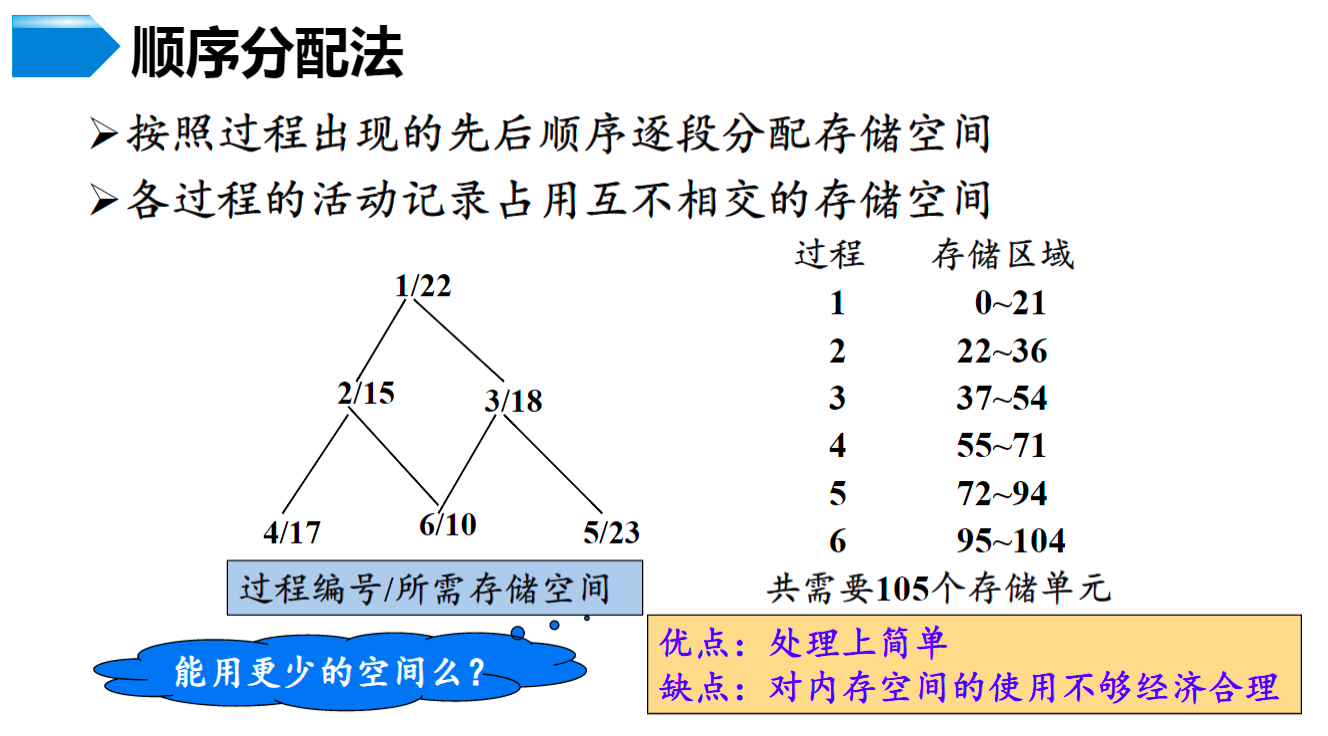
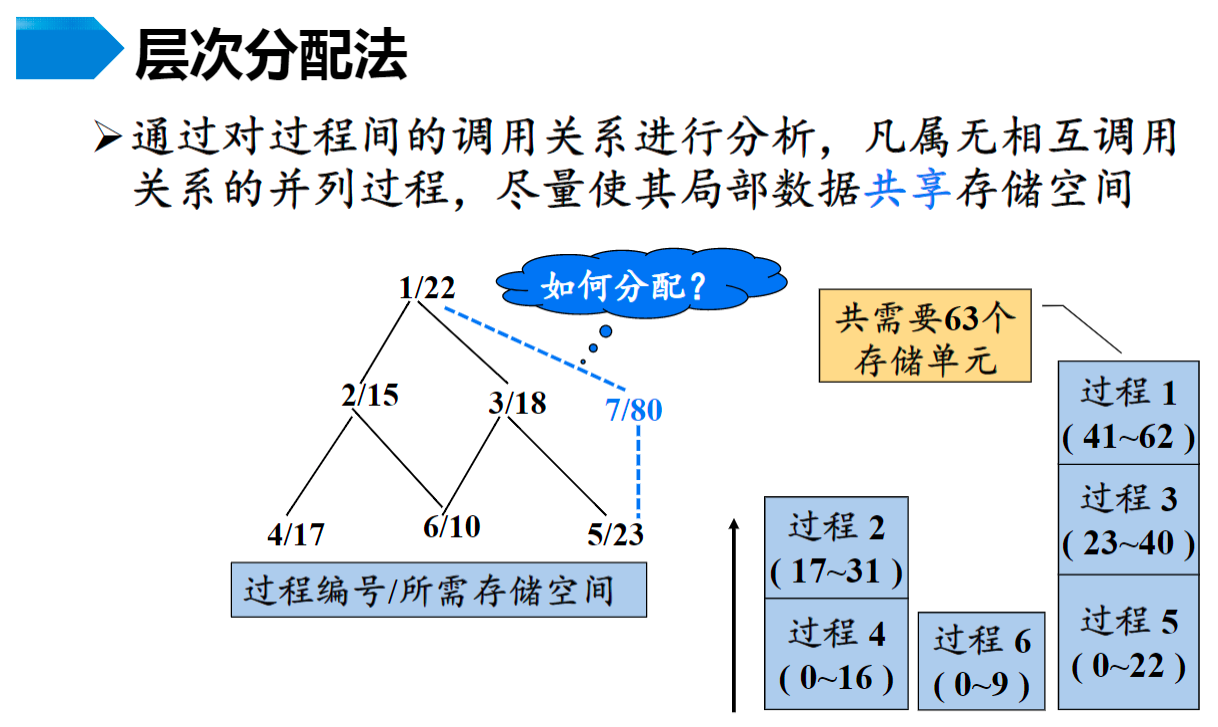
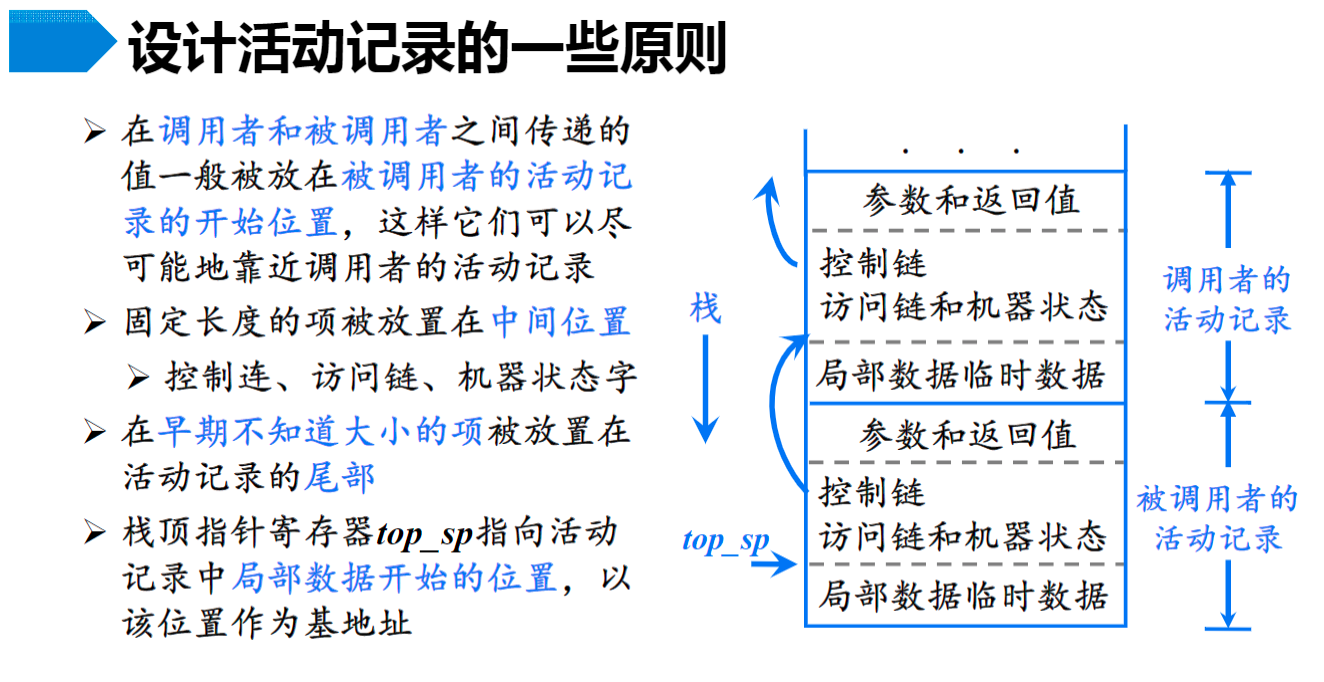
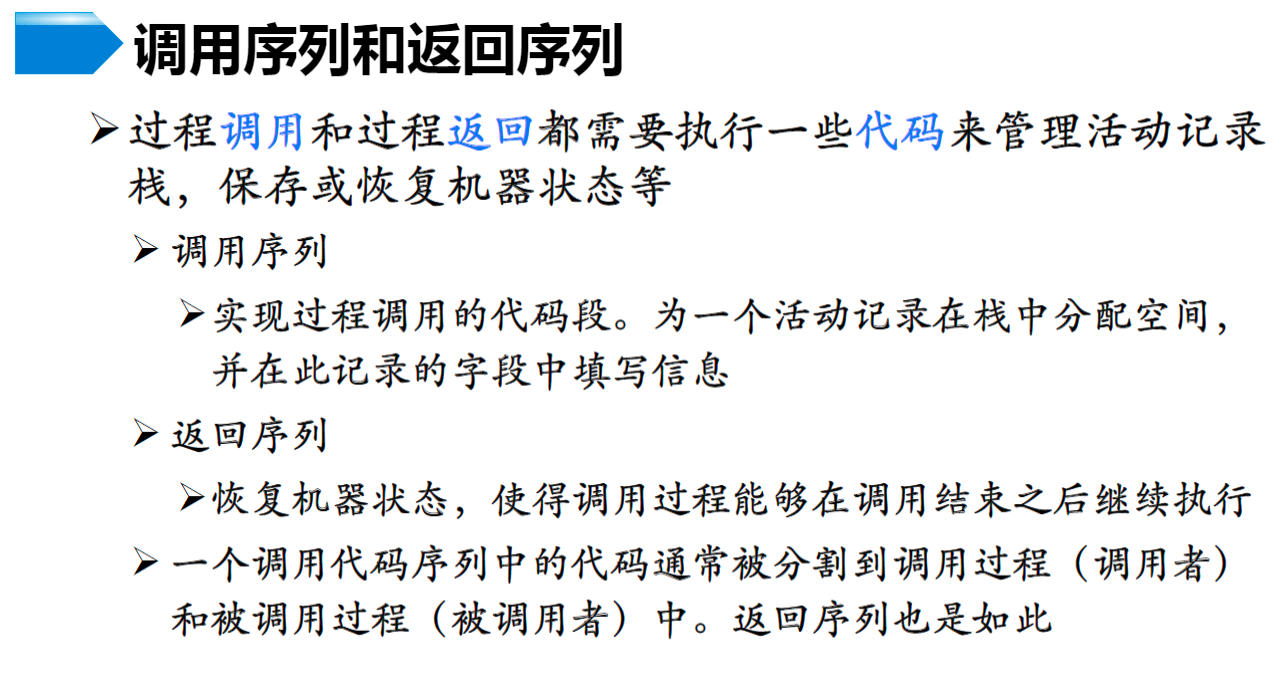
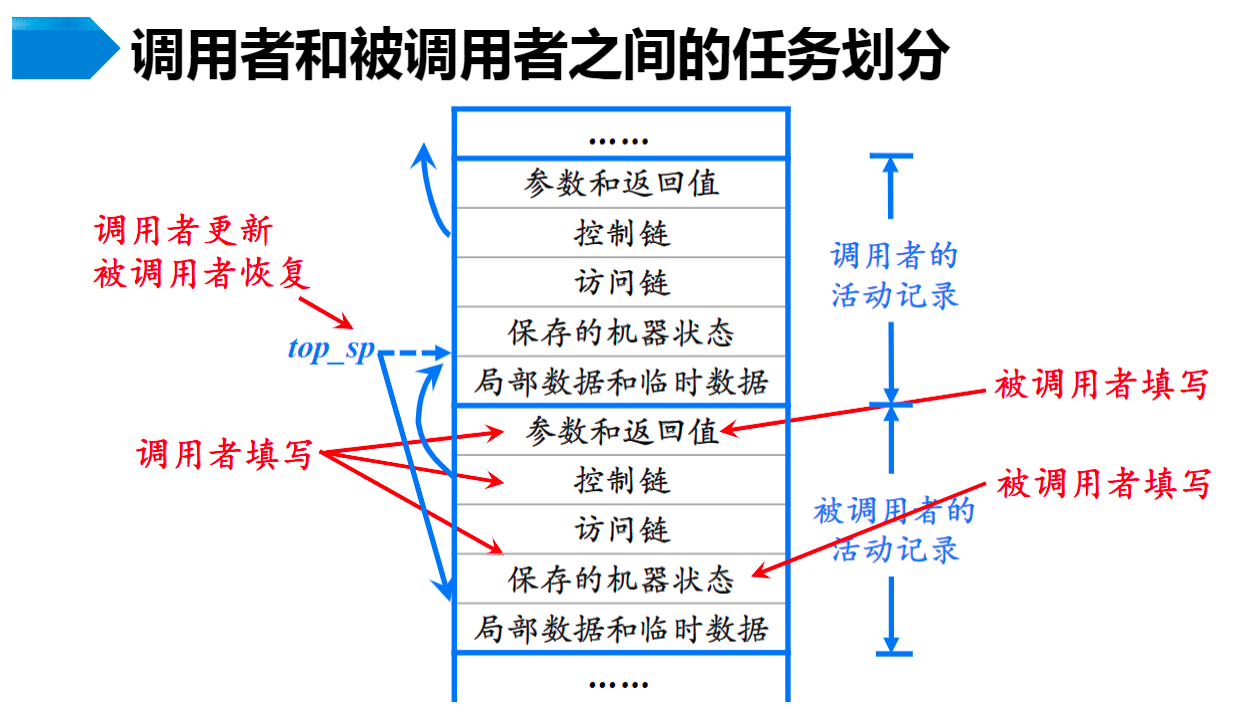
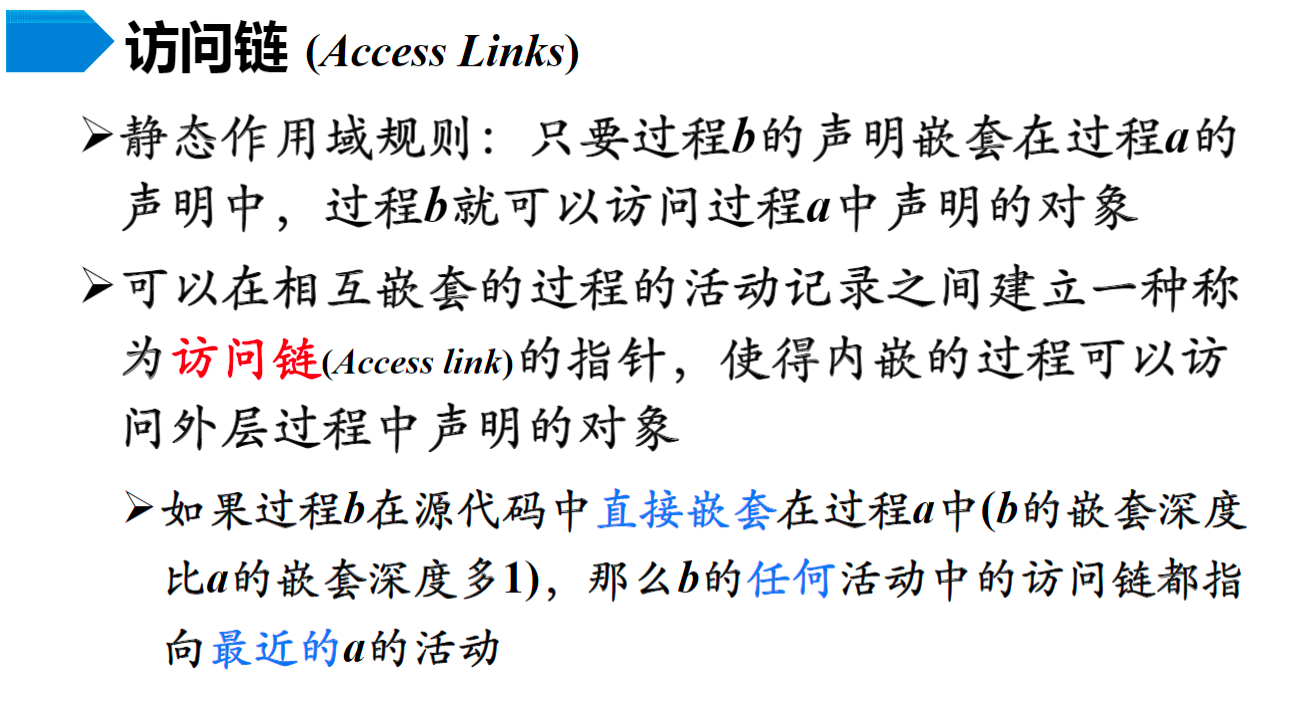
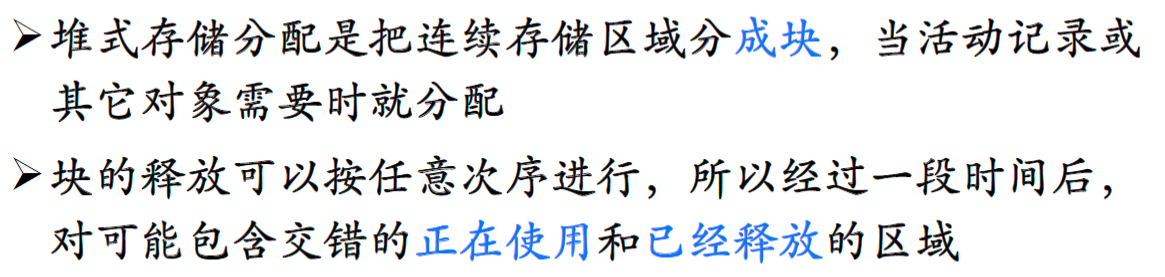
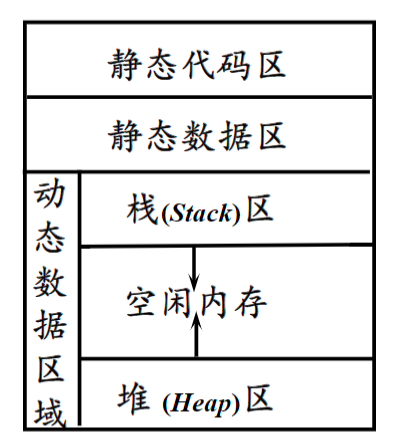
# 存储分配 ![9b02442450d205e02f94f6f89d500a9e.png](/resources/de7755762d3a4c5f9607f2856999a656) - (静态)代码区:代码经编译产生的机器语言存放的位置,可由目标代码生成过程直接确定空间大小,因此静态存储。 - 静态数据区:大小和结构与运行时无关的数据,如全局变量、全局常量等存放的位置 - 动态数据区:大小和结构与运行时相关的数据存放的位置 - 栈区:存储每一个过程调用时的基本信息和过程作用域内数据。过程的一次调用可称为一个活动,因此此类数据称为每个活动的“活动记录”![e50f6c2c8275d867ac8eaa70b9d35379.png](/resources/13dcb0b1ed79446a9e4146cba5f3bec9) - 堆区:为相对不可控的且调用过程无关的动态内存分配任务保留的存储区域 ## 静态存储分配 只使用静态分析方法来分配内存,无法支持递归调用、动态内存分配。分为顺序分配和层次分配。 ![c437e6925a224d7d5be817ed76d6df13.png](/resources/055f6dbf9d524a2e9b62aa3e48704b42) ![f7b2367641333d9b0e53f4b5bb496d21.png](/resources/181a002bb4154130a845dff6c7cbc440) ## 栈式存储分配 即调用栈,用于存储活动记录,即过程或作用域的基本信息,以及作用域内的数据。数据一般是在编译时可确定长度,或者在运行时容易确定长度的,并且生命周期必须与该作用域一致。 ![c5feeccc9c056febe322cbb4c573833d.png](/resources/c4a397dfd29840c2b2faacd7e8f2fd2f) ![952ca50a248d6ed119a2be5b400b3667.png](/resources/99f0f9d5acf3412db22c054ab05f1426) ![3d8836b8449059f6bf3937dbc356b971.png](/resources/1e2bfb2e0ebf4a27a059c4fdebd0ff90) ![fe85997d6d482f3874af80fa6ee73508.png](/resources/364adc86532b4678b1fb37a175f09e18) ## 堆式存储分配 ![6f76c06cea7847ed3c795a056e075a7c.png](/resources/8f30681e3708407e8d2299de57d5f1c3) 堆中存储的数据通常被静态数据区或者栈区中的至少一个指针所指向,若没有,则其为无用或泄露的内存。 其余内容可以参考操作系统的内存分配技术,基本与堆式存储分配一致。 ## 符号表 为每个作用域(程序块)建立一个独立的符号表,其中存放该作用域中出现的符号标识符、类型和长度,以及对应堆/栈中的地址,便于进行字面量索引。