# AlexNet
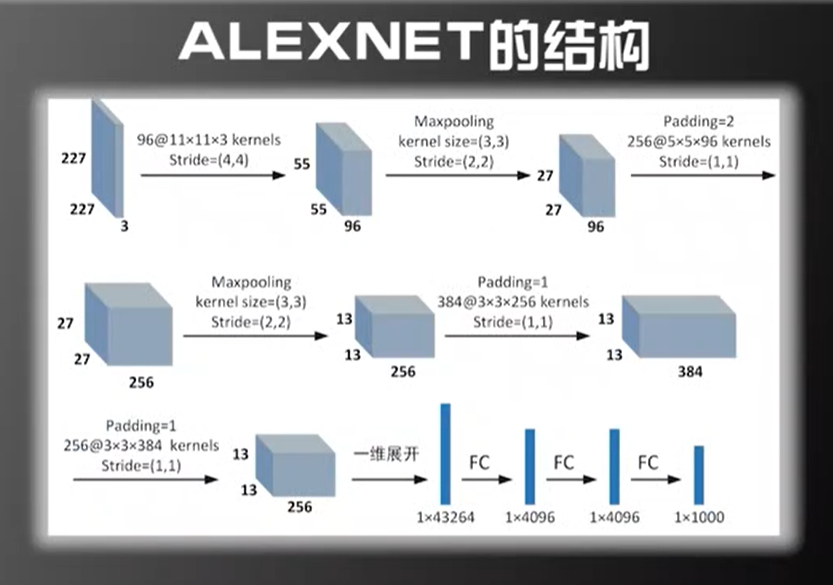
## AlexNet的突破
### 使用ReLU(Rectified Linear Unit, 线性整流单元)
- ReLU函数不产生梯度消失
- ReLU函数的<0一侧对下层网络来讲是休眠或部分休眠的,减少网络神经元更新,使网络更稳定,促进收敛
### 使用最大池化而非平均池化
- 在平均池化中,池化窗口尺寸为$m*n$,就需要将池化后的特征反向传播给$m*n$个上级特征,而最大池化只需要给一个最大值特征传递过去。这也使得网络更稳定
### 使用漏失(Dropout)机制优化训练
- 减缓了网络收敛的速度,但却能很大程度避免参数更新过快造成过拟合,也使得网络更加稳定和健壮
### 数据扩增(Data Augmentation)
- 水平翻转
- 切割采样
- 引入噪声
### 利用GPU加速训练过程
- 这个不用说了,牛哇
![]()