# 语法制导翻译-语法制导定义(SDD)
> 语法制导翻译是基于CFG的,即产生式左部必须是单个非终结符,右部是其展开式。
## 文法符号与语义属性,产生式与语义规则
- 每个文法符号都可以具有若干属性(语义属性)
- 每条产生式可以有若干语义规则,即对产生式内出现的文法符号(仅限非终结符)的属性的计算式,一般呈现为赋值语句
- 根据一条产生式的语义规则的具体定义,划分两种属性:
- 计算产生式左部非终结符的属性,则将此属性称为该非终结符的综合属性(synthesized attribute),感觉叫合成属性更好理解。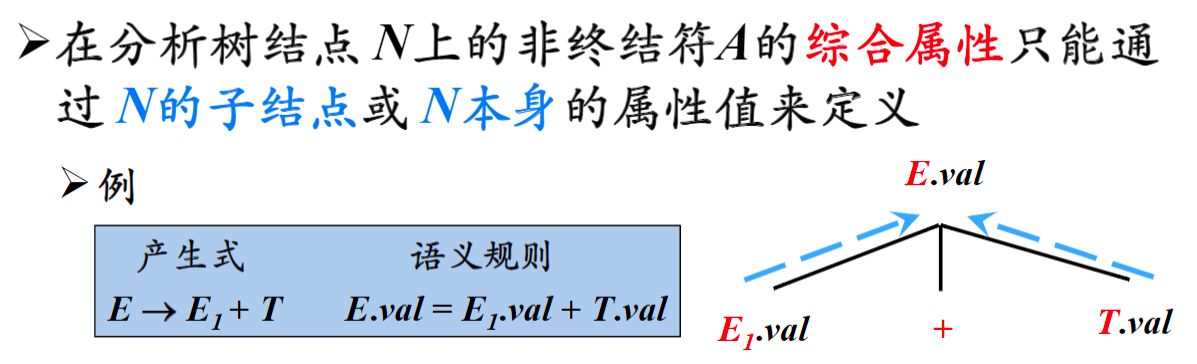
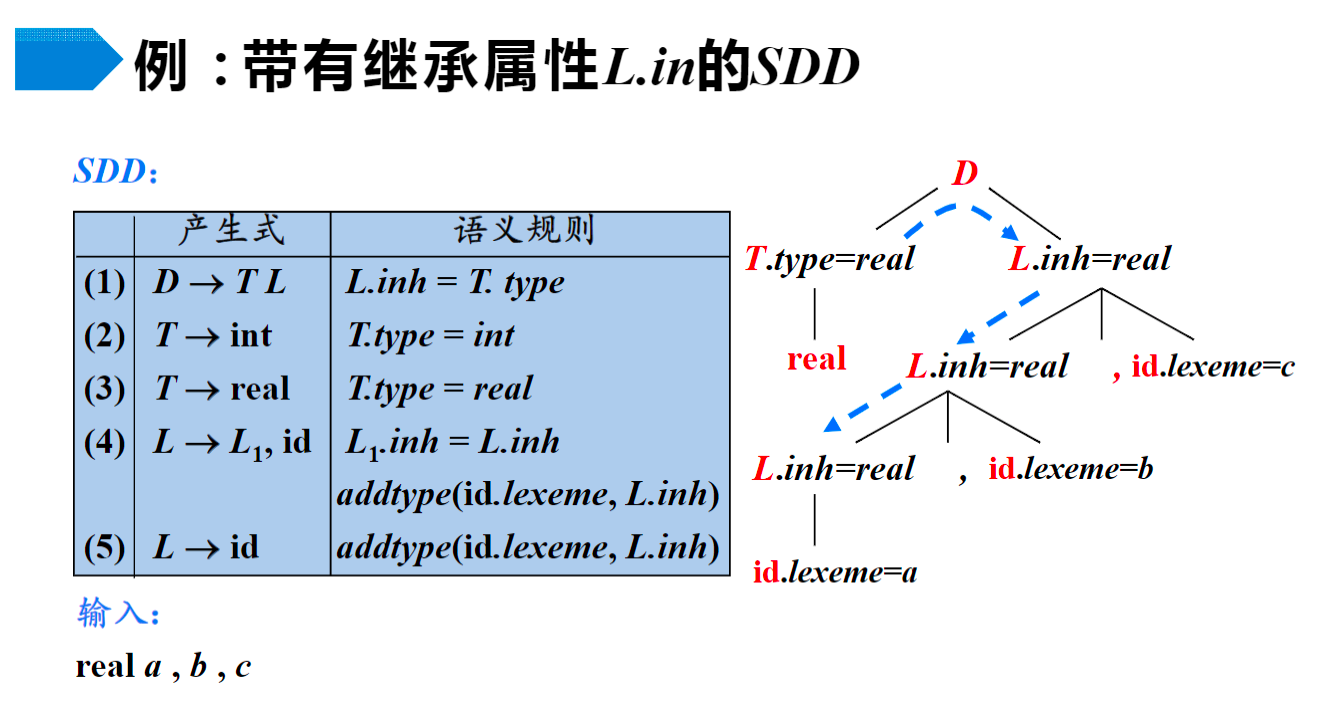
- 计算产生式右部出现的非终结符的属性,则将此属性称为该非终结符的继承属性(inherited attribute)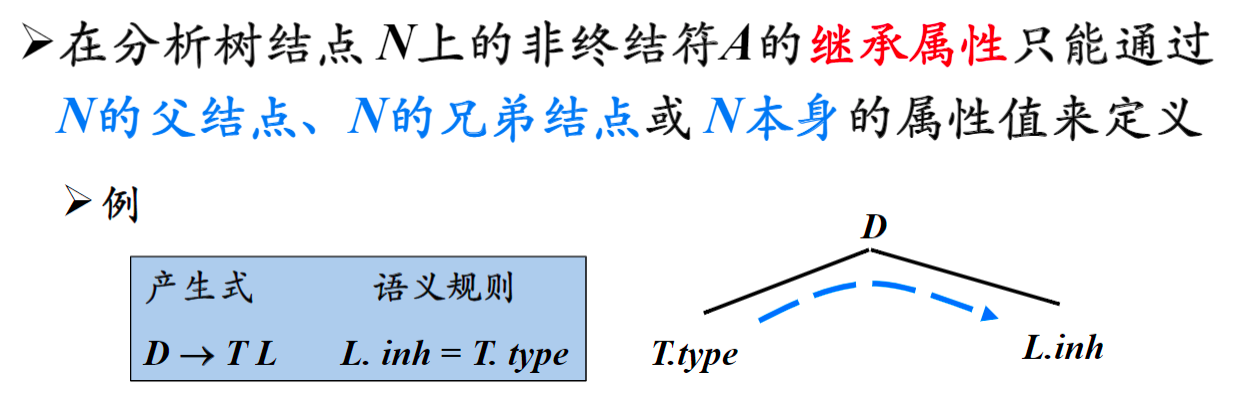
- 终结符只有词法分析给出的静态属性,即其字面量,也可视为一种特殊的综合属性
## SDD
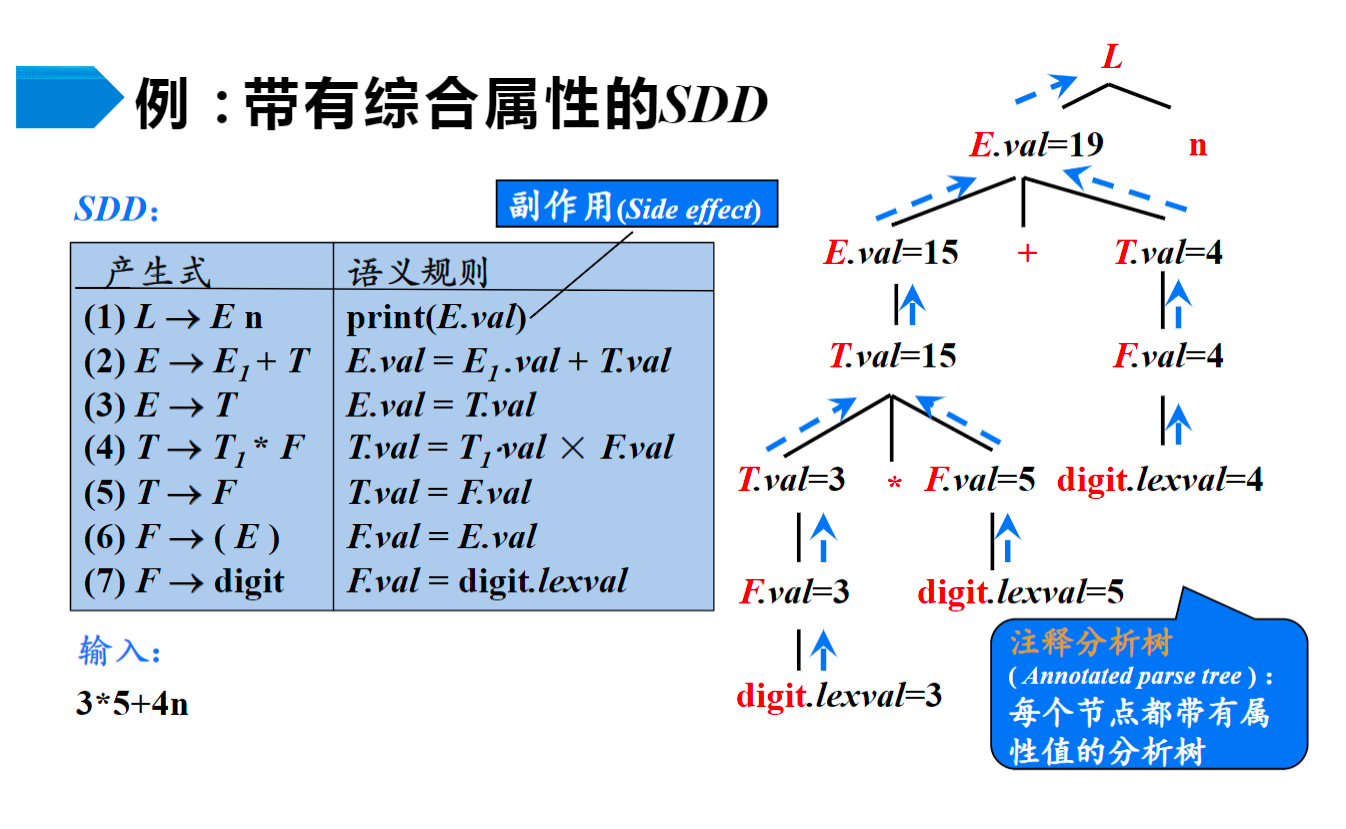
## SDD的计算图
由于SDD将属性的实际计算过程定义为数条赋值语句,赋值语句表达式中的属性一定是赋值目标属性的前置数据,必须提前计算。
因此把各个属性看作结点(副作用动作看作特殊的结点),属性间的必要条件关系作为弧,将形成一个有向计算图。若计算图无环,则对计算图拓扑排序,可得至少一个合法的计算顺序。
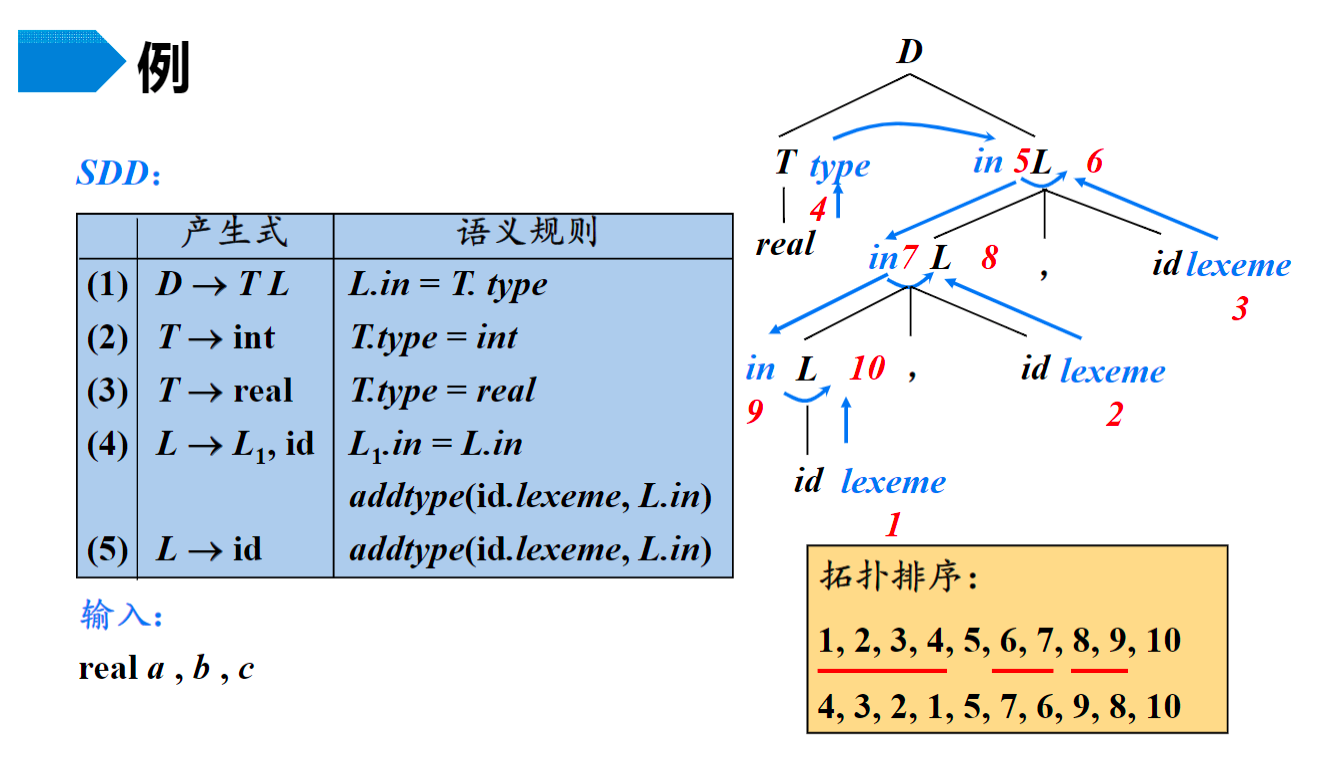
有典型的两种SDD,其必然形成DAG,分别为:
- S-属性定义(S-SDD),其中S指Synthesized
- L-属性定义(L-SDD),其中L指Left
## S-SDD
仅允许存在定义并计算**综合属性**的语义规则的SDD,称为S-SDD。易知其计算图为严格的与语法分析树同型的自底向上结构。
S-SDD可以轻松植入LR文法的分析(自底向上)方案中,实现语法制导翻译
## L-SDD
仅允许存在以下两种属性的SDD,称为L-SDD:
- 允许存在**综合属性**,与S-SDD一样没有限制
- 允许存在**某些继承属性**,以(A→X1...Xn)中计算Xi的继承属性为例:
- 允许使用**A的继承属性**进行计算
- 允许使用**X1...X(i-1)的任意属性**进行计算,不得使用X(i+1)...Xn
- 允许使用Xi本身的属性进行计算,但此时不得有环路
- 可见L-SDD的计算图套入语法分析树后,必然为一个只有要么自底向上,要么自左向右的弧的DAG
- 每个S-SDD都自然为一个L-SDD
L-SDD可以使用LL文法的自顶向下分析实现语法制导翻译,也可以稍加改造后使用LR文法的自底向上分析实现语法制导翻译。
![]()